让 LLM 自己迭代改进 agent 的 harness——自动改 prompt、控制流、工具接口、记忆与上下文管理——已经是条成熟的做法。Google Cloud AI Research 这篇论文(arXiv:2609.24972,2026 年 9 月,附 Apache 2.0 代码库)量化了它的另一面:同一预算下跑四种已发表的 harness 进化方法,在进化用的任务集上人人都涨分;换到没见过的基准,两个掉到不如从未进化过的原始 harness。论文提出的 RRSI 把机器学习里的正则化搬进进化的提出与选择两端。交易很清楚:进化集分数涨得少,换来六个 held-out 基准全部不回退、跨模型可迁移,以及少三成的推理 token。
成稿为全结构的观点重述,非逐句对译;数字与结论保真,图表用论文原图。
harness 为什么值得单独优化
论文的出发点一句话:现代 LLM agent 是系统,不是单体模型。冻结的 backbone 外面裹着一层 harness——系统与任务 prompt、决定何时计划/行动/反思/停止的控制流、工具接口与描述、可查阅的记忆与技能文件、决定每步上下文的管理逻辑。同一个模型会不会先读再改文件、能不能从失败命令里恢复、上下文是否高效,都由这层决定。论文引工程报告说,近年 agent 产品的进步有相当一部分来自 harness 工程而非新权重。
这工程至今靠人工:读失败轨迹,手改脚手架,进度受限于工程师能读多少条轨迹。于是出现把环路自动化的整条研究线——LLM 提出组件级修改,按基准分数决定去留。论文把它视为 agent 系统层面的递归自我改进(recursive self-improvement, RSI):系统跑出来的反馈,被用来改进塑造它后续行为的 harness。
病灶:自适应过拟合
要害在于进化集被自适应地复用。第 t 轮的候选修改,基于同一批有限任务在早先轮次的测量结果提出,又在同一批任务上打分筛选。这是自适应数据分析里的经典风险场景。论文把过拟合拆成三种互相耦合的行为:
- 基准特异性拟合:搜索把任务名、实体名、任务特定取值直接编码进 harness;
- 噪声追逐:随机评测波动里的赢家被选成永久状态;
- 复杂度累积:改进进化集分数、却不改进底层机制的改动不断堆上去。
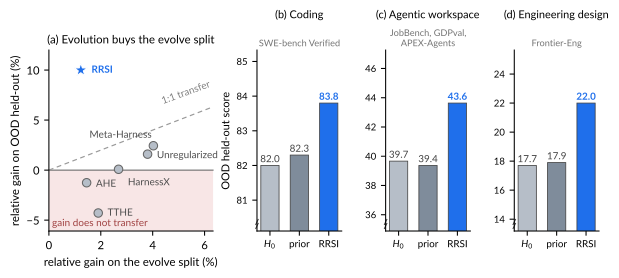
图 1 ·(a)各方法在进化集的涨分对分布外涨分。(b–d)未进化 harness H₀、四个先前方法的平均、RRSI 在三个域 held-out 基准上的分数。
数字直说。Harvey LAB 上进化、同一起点同预算:四个基线方法(Meta-Harness、AHE、TTHE、HarnessX)在进化集全部涨分,分布外平均只有 Meta-Harness 拿到 +0.9;AHE 与 TTHE 掉到低于起点,TTHE 低 1.7 分。按进化集分数选 harness,可能选出一个比没进化过更差的 harness。
RRSI:正则化搜索,不锁编辑空间
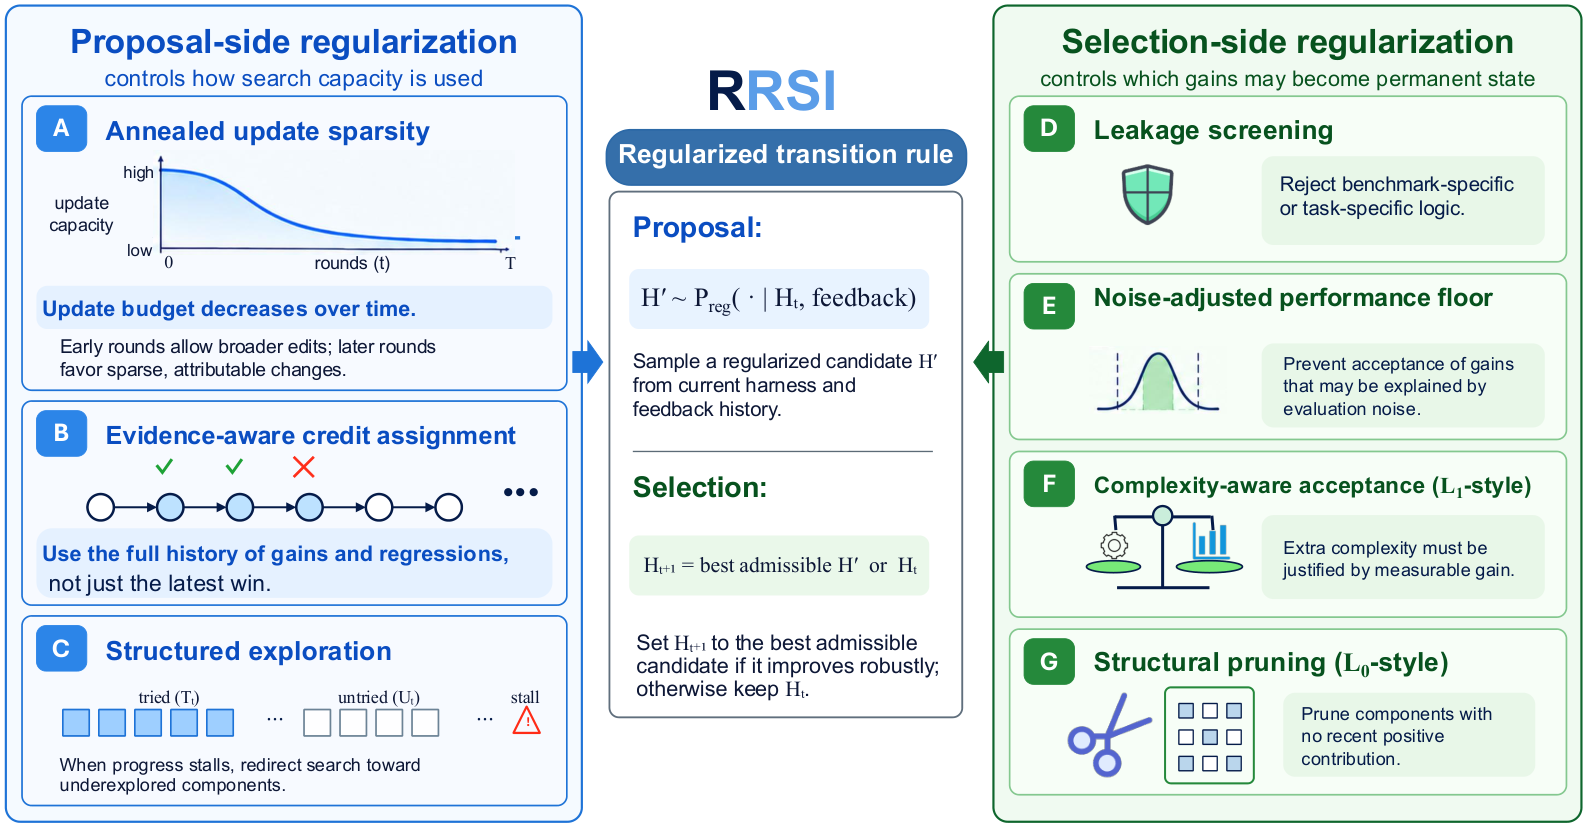
图 2 · RRSI 正则化的是穿过编辑空间的搜索轨迹,不收窄编辑空间本身。
RRSI 不限制 harness 的可编辑范围:prompt、控制流、配置、上下文管理、工具、技能、记忆、子 agent 都可以增删改。它约束的是搜索在这个空间里怎么走。作者反复声明 L₀/L₁/L₂ 只是复杂度控制上的类比,不是在优化对应的范数罚目标。
提出端三招,管的是单轮反馈能动用多少自适应容量:
退火编辑预算(类比 L₀)把一条反馈能触发的东西限死:每个候选可捆绑的「可独立归因的修改」数按余弦日程从 b_max 退火到 b_min,早期允许捆几个协同修改去发现新机制,后期一次一个、越来越可归因。
证据感知的功劳分配让搜索记得自己否证过什么。每条被评估过的原子修改都记录在案——改了哪个组件、检验的假设、diff、分数与成本变化、是否被接受——提出者后续轮次以此为条件。被否证的机制留作负证据,不再反复花预算重试。
结构化探索对付另一种坍缩。过去 w 轮的进度都落在经验噪声带 δ 之内,即视为停滞;停滞时预留一小部分提案名额给整个运行中从未动过的组件。不这样做,搜索迟早缩成「反复改 prompt、从不碰结构」的窄族。
选择端四道闸,管的是哪些测得的改进有资格变成永久状态:
打分之前,先过泄漏筛检:一个 critic 读候选 diff,拒绝显式编码任务名、实体名、任务特定值、答案或进化基准特有逻辑的修改。筛在打分前做是有讲究的——泄漏的候选拿不到那个会诱惑后续轮次的虚高分数。
噪声地板在进化开始前就量好:反复评测未进化的基线 harness,估出经验噪声带 δ,候选必须满足 Ŝ(H′) ≥ S* − δ(S* 为历史最好分)。这条地板挡的不是单次回退,是一串各自小到像噪声的回退把搜索一路带下坡。
成本线(类比 Ridge/L₂)只管分数增量超出噪声带的候选:成本增量必须满足 ΔC ≤ β₀ + β₁·ΔS。多花的推理 token 要由测得的涨分买单。β 在进化集上定好,对一切迁移评测固定。
最后一道是剪枝(类比 Lasso/L₁),它作用于留存下来的 harness 而非单次更新:固定窗口 n_prune 内没有产生严格正收益的组件,被报告为后续提案的删除目标。机制必须持续挣得位置——只看分数的进化没有删除激励,这道闸是补上去的。
实验怎么搭
三个域、八个基准。编码域在 Terminal-Bench 2.1 上进化(89 个容器化终端任务,任务自带隐藏单测),SWE-bench Verified 的仓库级真实 issue 修复作迁移。workspace 域的进化集是 Harvey LAB 的 160 个法律实务任务,一次性切成 120 进化 + 40 held-out,JobBench、GDPval、APEX-Agents 三个基准作迁移。工程设计域最小:EngDesign 免许可子集 61 个任务,Frontier-Eng 作迁移。
backbone 全程冻结 Claude Opus 4.8,提出者、跨轮失败反馈的分析者、泄漏 critic 也是同款。起始 harness 分别是 Terminus-2(编码)、跑在 MCP 网关上的 ReAct 环加动态工具带(workspace)、ReSum 式上下文管理。基线四个:Meta-Harness 把 harness 工程做成对可执行 harness 代码的外环优化;AHE 用可观测性驱动的进化环诊断失败、评估历史改动;TTHE 在测试时保持多个候选 harness、由 agentic judge 挑选;HarnessX 把 harness 表示成模块化类型化原语的组合,靠执行反馈适配。
判分细节里几条值得记住。Harvey LAB 每个任务 20 到 100 条 rubric 判据,一次完整评测约 14,000 条判定,缺交付文件的任务其名下全部判据计零分。GDPval 是 185 个任务、三个不同来源的评委(本地部署的开源模型加两家的商用模型)、双向呈现去位置偏置、多数决,报的是对人类专家的胜率。APEX-Agents 480 个任务 pass@1,基础设施失败导致缺 rollout 的任务计零分而不是剔除——在难任务上崩掉的 harness 占不到便宜。工程设计的两个基准由各自冻结的仿真器或测试台判分,确定性,没有判分模型。
主结果:分岔只出现在分布外
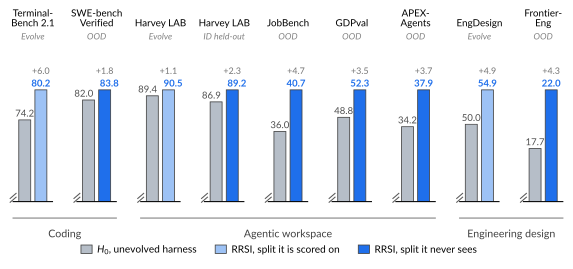
图 3 · 每个数字都对同窗口测量的未进化 harness H₀ 报告,涨分无法归因于评测基础设施的漂移。
进化集涨 6.0(Terminal-Bench 2.1)、4.9(EngDesign)、1.1(Harvey LAB)。论文强调的是离开进化集之后剩下的部分:SWE-bench Verified +1.8——仓库级修 bug 从没被打过分;Harvey LAB 的同分布 held-out +2.3;workspace 三个分布外基准 +3.5 到 +4.7(相对 7.2%–13.1%);Frontier-Eng +4.3 Medal 分(相对 24.3%)。没有任何 held-out 切分回退。
| 方法 | Harvey LAB(进化) | Harvey LAB(ID held-out) | JobBench | GDPval | APEX-Agents |
|---|---|---|---|---|---|
| H₀(未进化) | 89.4 | 86.9 | 36.0 | 48.8 | 34.2 |
| Meta-Harness | 93.0 | 89.2 | 37.1 | 49.1 | 35.7 |
| AHE | 90.7 | 88.7 | 37.2 | 47.2 | 33.1 |
| TTHE | 91.1 | 88.5 | 35.2 | 47.0 | 31.7 |
| HarnessX | 91.8 | 89.1 | 36.3 | 48.5 | 34.3 |
| RRSI | 90.5 | 89.2 | 40.7 | 52.3 | 37.9 |
表 1 · agentic workspace 任务上与先前 harness 进化方法的对比,同一起点、同一进化切分、同一候选预算。
表 1 的读法:每个基线在进化集都好使,同分布 held-out 差不多,分岔出现在分布外,排序在那里倒过来。RRSI 的进化集分数是六个里最低的(90.5),分布外平均 43.6 对起点的 39.7——唯一高出起点一分以上的进化方法。这正是正则化设计好的交易。
还有一个容易漏掉的质疑被论文提前关掉:Harvey LAB、JobBench、GDPval 都是判分模型打分,harness 理论上可以学会写判分器爱看的文风而不是产出更好的活。工程设计域堵死了这条路——冻结仿真器判分、确定性、设计要么满足约束要么不满足——涨幅在那里原样保持。
拆开看:两组正则各管什么
| 变体 | Harvey LAB(进化) | ID held-out | OOD 平均 | token/次试验 ↓ |
|---|---|---|---|---|
| H₀(未进化) | 89.4 | 86.9 | 39.7 | 1.56M |
| 无正则进化 | 92.8 | 88.9 | 40.3 | 3.80M |
| 去掉提出端正则 | 90.7 | 88.8 | 41.9 | 2.69M |
| 去掉接受端正则 | 91.5 | 88.7 | 41.0 | 3.59M |
| RRSI | 90.5 | 89.2 | 43.6 | 2.42M |
表 2 · agentic workspace 实例上的消融。OOD 平均是 JobBench、GDPval、APEX-Agents 三者均值。
去掉哪组正则都是同一形状:进化集分数上去,迁移下来。去掉接受端,进化集 90.5 涨到 91.5,分布外平均从 43.6 掉到 41.0,token 涨一半——论文的判词是,不受约束的接受规则把通过的修改大多花在噪声和上下文上,花不到机制上。去掉提出端只损失进化集 0.2 分,分布外却少 1.7 分:什么都不拒,把搜索往哪看也有贡献。两组都去掉,进化集 92.8 全场最高,分布外 40.3 与没进化过几乎持平,每次试验烧 3.80M token。
换个 backbone 还成立吗
| 策略 | 基准 | H₀ | RRSI | Δ |
|---|---|---|---|---|
| Claude Opus 4.8 | Terminal-Bench 2.1(进化) | 74.2 | 80.2 | +6.0 |
| SWE-bench Verified(OOD) | 82.0 | 83.8 | +1.8 | |
| Gemini 3.5 Flash | Terminal-Bench 2.1(进化) | 64.6 | 78.7 | +14.1 |
| SWE-bench Verified(OOD) | 76.8 | 79.0 | +2.2 |
表 3 · 策略鲁棒性:编码域进化用不同家族的冻结策略各自跑,得到的 harness 原样评测。
| 评测策略 | H₀ | RRSI | Δ |
|---|---|---|---|
| Gemini 3.5 Flash(搜索用策略) | 64.6 | 78.7 | +14.1 |
| Gemini 3.1 Flash Lite(未参与搜索) | 11.2 | 14.6 | +3.4 |
表 4 · 跨模型迁移:Gemini 3.5 Flash 进化出的 harness,换到从未参与搜索的更小模型上跑 Terminal-Bench 2.1。
论文的论点是 harness 是程序,不是权重——只对搜索时那个策略有效的机制是那个策略的伪影,不是可复用的机制。两个模型家族各自独立进化,模式相同;Gemini 3.5 Flash 进化出的编码 harness 原样换到 Gemini 3.1 Flash Lite 上,11.2 涨到 14.6,相对 30.4%。绝对涨幅小是因为更弱的 backbone 够得着的任务本来就少。
成本:唯一更轻的进化 harness
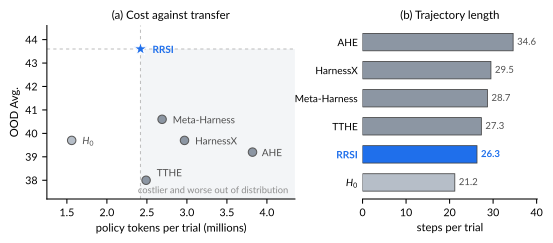
图 4 · 四个先前方法都花更多 token 拿更低分布外分;RRSI 是最轻的进化方法。
两条正则直接作用于成本:成本线拒掉不为涨分买单的增长,剪枝删掉后来不再买单的增长。先前方法一个都没带这两条。无正则进化每次试验 3.80M policy token,RRSI 2.42M;AHE 是极端值,3.82M——比 RRSI 多 58%,分布外还低 4.4 分。轨迹步数同方向:RRSI 26.3 步,先前方法 27.3 到 34.6 步。论文没有回避另一半真相:没有任何进化 harness 便宜过 H₀(1.56M token、21.2 步),进化的一部分涨分本来就是拿测试时算力换的——预算决定换多少。
附录里值得拿出来的三样东西
算法怎么落地。 每轮分两侧。提出侧:分析当前 harness 在进化集的轨迹得反馈,按余弦日程算预算 b_t,判定是否停滞,算出未被碰过的组件集合与剪枝目标,然后从正则化的提出分布里抽候选,每条原子修改打上组件与假设标签。选择侧:候选并行评测,算 ΔS 与 ΔC;ΔS 超出噪声带走成本线,落在噪声带内走带内规则 w_s·ΔS − w_c·ΔC + w_n·ν > 0——ν 是候选触到的、从未进过胜出修改的结构组件种类数。通过噪声地板、成本或带内规则、领域守卫三关的候选里取最高分;一个都没有就保留现任。编码实例把 w_s 设成 0:落在噪声带内的涨分本身不能让候选过关,只能靠降成本或结构新颖度挣资格。而新颖度只算结构组件——client_tool、skill、memory、subagent 这四类;改 prompt 不给这个加分。
超参数。 全部只在进化环境上定,held-out 与分布外基准不参与调参。δ 的换算最直观:编码实例 δ=0.017,相当于 89 个任务 × 2 次试验共 178 次里的 3 个通过;workspace 实例 δ=0.004,相当于约 14,100 条 rubric 判定里的 60 条。预算 (b_min, b_max) 三个实例分别是 (1,4)、(1,3)、(1,4),轮数 20/20/40,剪枝窗口 4/4/5。β₁=44.5 在编码实例的含义是每多通过一个任务,允许 25% 的 token 增量。
案例。 附录 E 给了四条真实的进化决策。编码第 0 轮两个表面相似的候选:一个加了有界的完成前核查与非阻塞轮询指引,进化集 +3.93,接受——可复用的行为机制配得上早期较大的改动;另一个加了类似的核查提醒,+1.69 但多花 26.1% 成本,被成本线拒绝——落在噪声带内还要大幅加算力的「改进」不自动保留。第 8 轮有个候选把任务原文钉进提交门,−2.81 分、省 13.6% token,被地板拒绝——省成本救不了跌破地板的候选。工程设计第 2 轮,一条针对反复出现的 “workdir must be an existing directory” 报错的恢复提示,通过数 122/244 涨到 128/244,只多 1.6% token,接受——小的、任务无关的控制流修复留得下。
局限(作者自陈)
研究只覆盖 backbone 冻结条件下的 harness 层自我改进,不涉及进化中更新权重;RRSI 仍依赖有限进化集与若干正则超参,效果受反馈信号质量与搜索预算影响;跨了多个域、基准与策略模型验证迁移,但更异构的架构、工具生态与更长程的自我改进过程还需更多验证。
编注:对维护 harness 资产库的启示
以下为编者引申,非论文内容。
这篇论文对本库的直接价值,是给「如何维护一套给 coding agent 的 harness 资产」提供了实验背书,而本库的几条硬规则恰好是这些正则化的人工版本。「一个资产一个 markdown」「反模式必填」对应 L₀ 预算——改动小而可归因,涨跌才知道归功或归罪于谁;「登记卡不与上游技能争夺触发词」对应泄漏筛检——项目特异的逻辑不该沉淀成永久状态;DESIGN.md 的「Prefer removing over adding」对应剪枝——没有证据的组件要删,score-only 的演化不会自发删除,人来补这道闸;成本线则提醒,每加一层技能、一条规则,都在向每次会话征收 token 与注意力税,新增必须由可测量的收益买单。
更实用的一条:如果你在用或打算用任何「自动进化 harness」的工具调自己的 agent 配置,先问它有没有泄漏筛检和噪声带。没有的话,表 1 说明了你会得到什么。