想让 agent 在无人值守时把代码写完,业界换过好几代编排方案,从 agents、swarms 到 meshes、orchestrators,都是给 agent 加一层管事的结构。Matt Pocock 在视频 Ship working code while you sleep with the Ralph Wiggum technique 里给出的做法简单得多:一段 bash 循环,每轮把同一份任务清单交给 agent,让它挑一条做完、验证、提交,再进入下一轮。他试过不少 AI 编程编排方案,认为 Ralph 比其中任何一种都强出一大截。本文根据这期视频的中文整理稿,梳理 Ralph 的五个部件、它的 prompt 怎么写,以及它依赖的反馈回路。
这个做法出自 Geoffrey Huntley 的原始文章,7 月 14 日就已发出,最近才热起来。原因在于它把编排压到最简,要求落在底层模型身上,模型不够强就撑不起来。Opus 4.5 和 GPT 5.2 相继发布后,模型能力够了,这类简单做法重新可行。Matt 另写过一篇 Ralph 的 11 条技巧。
三种让 AI 做完清单的办法
Matt 借敏捷的说法描述工程师的日常。手上有一个 sprint,也就是一批必须完成的小任务,工程师逐条领走,在 sprint 结束前做完。sprint 一般有一到两周的时间盒。AI 不知疲倦,时间盒可以去掉,AI 编程里的 sprint 就剩一张排好顺序的任务清单。
让 AI 做完整张清单,有三条路。
- 开 16 个 agent,每个领一条。 合并冲突会大量出现,任务之间还藏着不易察觉的依赖。
- 让一个 agent 逐条做完全部。 任务合起来放不进一个上下文窗口,模型会混乱,代码质量很差。AI 的耐力没有上限,上下文窗口有。
- 写多阶段计划。 这是当下多数熟练开发者的做法,也是 Matt 在发现 Ralph 之前的做法。在 Claude Code 的 plan mode 里生成一份 markdown 大计划,写清每个阶段的具体动作,再让模型一阶段一阶段推进,每段之间清空上下文。
多阶段计划的代价出现在加任务的时候。新条目要插进两条之间,人得判断它在计划里的准确位置,理清依赖箭头,找出正确的执行路径。模型可以帮忙,前期仍要投入大量工作。计划写得越细,改一处就越贵。Matt 还觉得它不符合工程师的实际工作方式。
| 对比项 | 多阶段计划 | Ralph 循环 |
|---|---|---|
| 任务怎么排 | 阶段与依赖关系提前写死 | 每轮只抓最高优先级的那一条 |
| 加新任务 | 要重排整张计划 | 直接追加一条 |
| 完成状态 | 散在计划文本里 | 数组里的 passes 标志 |
| 每轮上下文 | agent 要读完整个计划 | 只装当前这一件事 |
工程师本来就在循环
真实的工程师先看 Kanban 板,判断下一条该做什么,领走、做完,回到板上,发现那条已经消失,再挑下一条优先级最高的,直到 sprint 结束。设计 sprint 时只需描述功能最终该是什么样;要加任务就加一条,相当于给最终形态补一份规格说明。
这条动作链本身就是循环:给定一批任务,模型领走并完成一条,等到没有可做的了,循环结束。Huntley 说的 Ralph 就是这个循环,用 bash 写成,给模型一批任务反复运行,直到做完。
ralph.sh:驱动循环
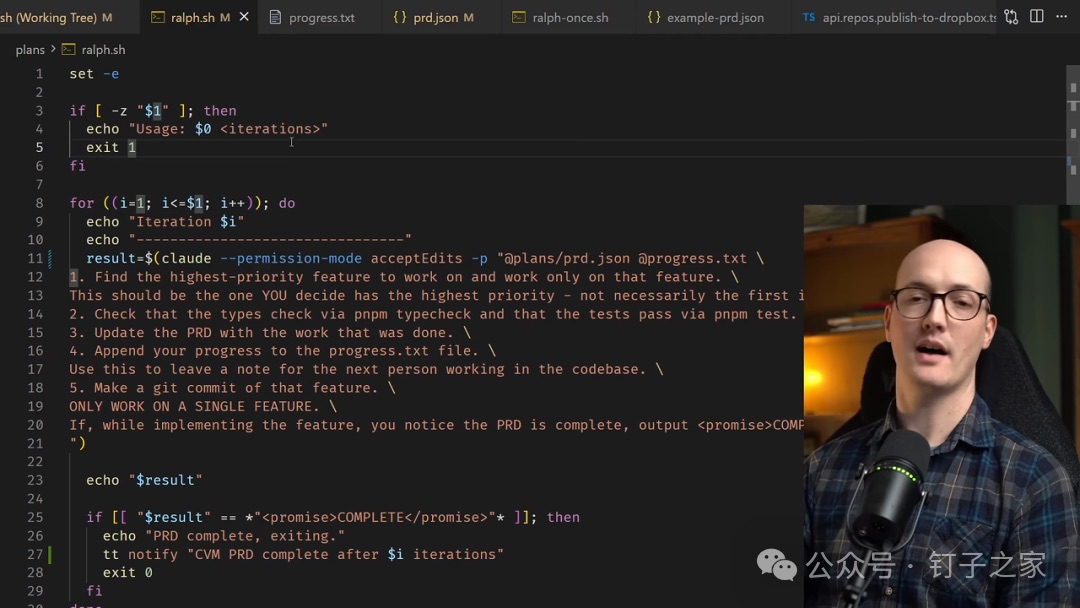
演示仓库是 Matt 自己的 course-video-manager,这个应用他用来剪视频、管理课程,也让 AI 帮忙写文章,代码有一定复杂度。Ralph 的全部零件在 plans/ralph.sh 这一个文件里。
set -e

if [ -z "$1" ]; then
  echo "Usage: $0 <iterations>"
  exit 1
fi

for ((i=1; i<=$1; i++)); do
  echo "Iteration $i"
  echo "--------------------------------"
  result=$(claude --permission-mode acceptEdits -p "@plans/prd.json @progress.txt \
1. Find the highest-priority feature to work on and work only on that feature. \
This should be the one YOU decide has the highest priority - not necessarily the first in the list. \
2. Check that the types check via pnpm typecheck and that the tests pass via pnpm test. \
3. Update the PRD with the work that was done. \
4. Append your progress to the progress.txt file. \
Use this to leave a note for the next person working in the codebase. \
5. Make a git commit of that feature. \
ONLY WORK ON A SINGLE FEATURE. \
If, while implementing the feature, you notice the PRD is complete, output <promise>COMPLETE</promise>. \
")

  echo "$result"

  if [[ "$result" == *"<promise>COMPLETE</promise>"* ]]; then
    echo "PRD complete, exiting."
    tt notify "CVM PRD complete after $i iterations"
    exit 0
  fi
done
脚本分四段。
set -e打开错误模式,任何一步出错脚本就停,不会带着失败的步骤继续往下走。- 必须传入最大迭代次数,不带参数运行会打印用法说明后退出。
for循环跑满次数就停,这个上限防的是模型决定永远不结束。 - 循环体里调用 Claude Code。调用哪个 agent 不重要,OpenCode、Codex 都行,只要能从命令行调用。
- 每轮输出存进变量、打印出来,再检查里面有没有
<promise>COMPLETE</promise>这个哨兵串,有就提前退出。tt notify是 Matt 用 TypeScript 写的小命令行工具,跑完后通过 WhatsApp 给他发消息。
prd.json:需求文档兼待办清单
脚本交给 agent 的第一个文件是 plans/prd.json,里面是一组 user story,每条四个字段:category 标类别,description 一句话说清要做成什么样,steps 列出验证这件事的几条动作,passes 是布尔值,标记这条在应用代码里是否已经通过。
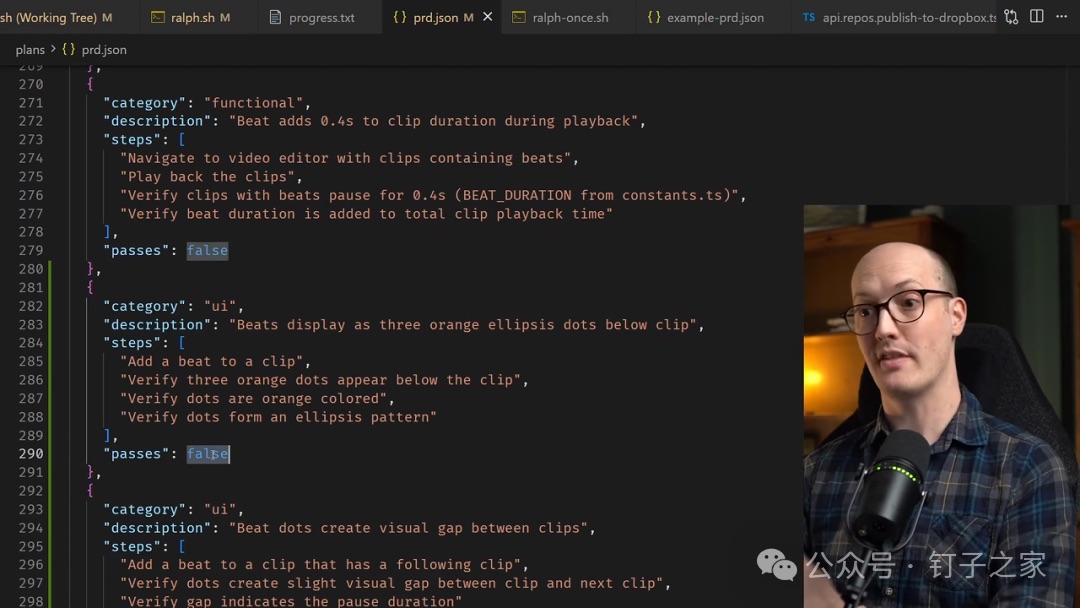
Matt 在视频编辑器里做过一个 Beats 功能,给片段末尾加一点停顿,界面上应该显示为片段下方的三个橙色省略号点。它在 prd.json 里是这样一条:
{
  "category": "ui",
  "description": "Beats display as three orange ellipsis dots below clip",
  "steps": [
    "Add a beat to a clip",
    "Verify three orange dots appear below the clip",
    "Verify dots are orange colored",
    "Verify dots form an ellipsis pattern"
  ],
  "passes": false
}
这份文件是跟模型一起迭代出来的。每条都带 passes,所以它同时是产品需求文档和待办清单:passes 为 true 的条目就算做完,模型不用再碰。
progress.txt:本轮 sprint 的记忆
第二个文件 progress.txt 是自由文本日志,模型把过程中学到的东西追加进去,比如这一轮实现了哪几条 PRD 条目。它代表模型在这个 sprint 里的记忆,sprint 结束时 Matt 通常直接删掉。prd.json 和 progress.txt 是模型每轮开始时拿到的输入。
视频里的条目以 --- 分隔,写明改了哪些文件、做了什么,最后一行是 Typecheck passes,还给下一轮留一句,例如 Next: PRD item #13 (duplicate path validation) still pending.
prompt 的五条要求
ralph.sh 里那段 prompt 给模型列了五步。
- 找出优先级最高的功能,只做这一个。 Matt 发现模型常常直接挑列表第一条,于是补了一句,由模型自己判断优先级,不一定是第一条。
- 确认类型检查和测试都通过,也就是
pnpm typecheck和pnpm test。 - 更新 PRD,模型通常会把对应条目标成
passes: true。 - 把进展追加到
progress.txt,给下一个接手代码的人留说明。这里用 append 很重要,写成 update,模型通常会重写整个文件。 - 为这个功能做一次 git commit,代码、PRD 和
progress.txt一起提交。每轮一个 commit,模型既能查 git 历史,也能读progress.txt,知道之前做过什么。
第 5 步后面那句「ONLY WORK ON A SINGLE FEATURE」防的是模型一次啃下超过自己能力的量。允许它一次处理一大批任务,等于让它一口气做完整个项目,上下文里 token 一多,模型就变笨,代码也跟着变差。
任务粒度同样要控制。清单里如果夹着一条特别大的任务,模型做到那条会被整个吞掉。设计 PRD 时让每条都足够小。这本来就是好的工程习惯,sprint 里排进耗时很长的大功能,对 AI 和对人都不好过。
反馈回路决定它能不能用
到这里 Ralph 的骨架已经齐了:一批任务、一个不断追加的 progress.txt、一个带兜底停止条件的循环。剩下的问题是怎么知道产出的代码能用,怎么避免它空转。
Ralph 要管用,必须配反馈回路。Matt 的项目用 TypeScript,pnpm typecheck 查类型,pnpm test 跑单元测试,Ralph 每次提交,CI 都必须保持绿色。反馈回路按成本从便宜到贵分三道:类型检查、单元测试、端到端验证。
Ralph 容易出的一种事故是提交了坏代码,下一轮记忆已经清空,找不到坏代码从哪来。这是任务要小的又一个理由。任务小,模型注意力集中,能写出正好覆盖这条 user story 的测试,改动范围小,质量通常更高。端到端验证可以接 Playwright 的 MCP server,效果很好,但相当消耗上下文,接上它就得把任务切得更小,给模型留出四处翻看、看截图的预算。
Matt 的不少做法来自 Anthropic 的 Effective harnesses for long-running agents,progress.txt 和 JSON 格式的 PRD 都来自那篇文章,JSON 格式本身就是它的建议。其中两条他照搬了:
- 只让 agent 改
passes字段,其余内容不许动,并配一句措辞很重的指令:It is unacceptable to remove or edit tests because this could lead to missing or buggy functionality. - 用 JSON 而不用 Markdown。 模型不太会乱改或覆盖 JSON。
那篇文章还观察到,Claude 倾向于在测试不到位时就把功能标成完成;明确要求它用浏览器自动化工具像真人用户那样测一遍,端到端验证的表现就好得多。
人在环版本:ralph-once.sh
上面讲的是 AFK 版(away from keyboard),可以整夜跑。仓库里还有一个 ralph-once.sh,prompt 几乎相同,只是跑在交互式终端里,跑一轮就停,人可以随时插手。Matt 做困难功能、需要大量引导模型时用它,用得相当频繁;它也是看清 Ralph 实际怎么干活的好办法。
视频里的一次运行用的是 Opus 4.5,Claude Max 5x 账号。模型读完 PRD,列出待办 #21、#23 至 #27,决定只做 #24「Beats 显示为片段下方三个橙色省略号点」。理由是视觉显示不做出来,其余与 beat 相关的界面项都没法验证。它列了个小计划,新建 beat indicator 组件并接到插入点上,随即跑类型检查和测试,都通过;又做了些额外验证,把 #24 标成 passes: true,在 progress.txt 里给下一轮留了提示,最后提交。
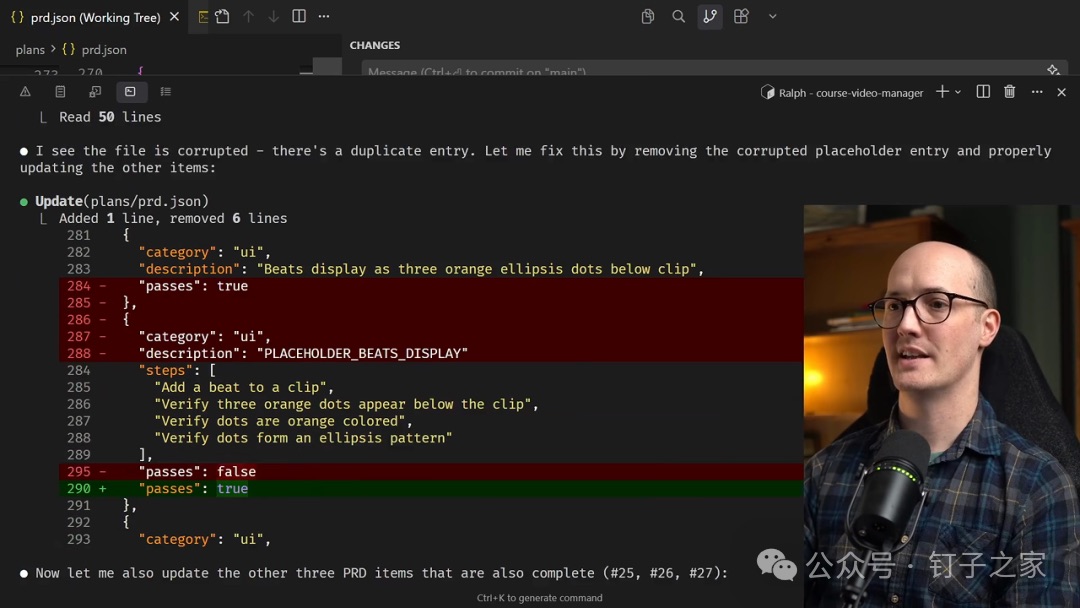
Matt 在编辑器里右键片段选 add beat,片段下方出现了三个橙色小点。想多做几条,重新执行同一条命令就再走一轮。他说即使在人在环版本里,这种从板上取一条、做完再取一条的方式也比写多阶段计划有效率。
五个部件
| 部件 | 作用 | 关键约束 |
|---|---|---|
ralph.sh | 驱动循环 | 必须传入最大迭代数,for 循环里带停止条件 |
prd.json | 需求文档兼待办清单 | 每条一个 passes 布尔值,只允许改这个字段 |
progress.txt | 跨轮记忆 | 指令写 append,写成 update 会被整篇重写 |
| 反馈回路 | 判断这一轮是否真做完 | 类型检查与测试必须通过,端到端验证最贵 |
| git commit | 每轮存档 | 代码、prd.json、progress.txt 一起提交 |
Ralph 把人放到了需求收集者的位置上,也就是产品设计者,注意力从功能怎么实现转到需要什么、该有什么行为。跑完之后,人过一遍代码、测一遍功能,需要的话再改 PRD。Matt 现在大部分代码就是这样写出来的:一个 AFK 版 Ralph,一个人在环版 Ralph,一份 prd.json。
他接下来打算在反馈回路上投入更多:更多、更可靠的测试,消除 flaky 测试(同一份代码跑两次结果可能不同的测试),再加一个能让模型探索应用的 MCP server。他认为最重要的是类型,越多越好,越强越好。
对于担心被落下的人,Matt 的说法是,dev 分支永远比 main 分支乱。大家都在试,有些可行,有些不行,很多东西还会变;过几年,怎么用这些工具会形成某种共识。他做这件事是因为喜欢这种编程方式,它比三个月前的做法更符合直觉。
想自己试,可以拿一个小项目,往 prd.json 里写三条足够小的任务,配上 pnpm typecheck 和一条测试,放进循环跑一轮。