想象一下,按外科医生的时薪,雇人整天给人量体温。这活不需要外科医生;只是外科医生恰好是你手上唯一的人手。
这正是眼下大多数 AI 系统内部正在发生的事,只是没人注意,因为「外科医生」是一段软件,不是一个人。
每一个 AI agent,不管是订机票的、整理收件箱的,还是发布前审代码的,大部分时间都在挑下一个该干的活,在检查某件事安不安全,在决定是还是否,根本不在写任何东西。小而简单的重复调用。而每一次这样的调用,都被发给了同一个模型。它又贵又慢,为写文章和对话而生,用它只是因为那是所有人手上唯一的工具。
这就像雇一位小说家来做选择题。小说家技术上当然做得了。这也是地球上最贵的打勾方式。
2026 年 9 月 15 日,一家叫 TypeSafe AI 的公司融了 4000 万美元,发布了专门为此造的东西:一个叫 Jev 的模型。它写不出一个句子,进行不了对话,你让它写它会拒绝。它只做判断这一件事。快、便宜,而且已经把真实 AI 系统的运行成本砍掉了最多 90%。
下面讲它的确切原理,以及怎么把它接进你正在跑的任何系统,从完整安装到真实代码,一步一步来。
Jev 这个名字来自的经济学问题
这个名字指向十九世纪的一条观察。动手写代码之前值得先弄懂它,因为它解释了为什么「等价格降下来」从来不是推理账单膨胀的真解药。
William Stanley Jevons 研究工业英国的煤炭消耗,注意到一件反直觉的事:蒸汽机烧煤效率越高,煤炭总消耗量不降反升。效率提高后,煤在从前不划算的地方也值得烧了,总用量随之爬升。
同样的机制在你的 token 账单上运转。更便宜的模型或调用降低的是「再插一个调用」的门槛,总支出不会因此下降。去年做三次模型调用的循环,今年做十一次。单次调用便宜到没人再过问了,工作量并没有涨。
TypeSafe 开出的解药是承认这些调用里有相当一部分从来就不是生成,把它们路由到按真实身份定价和构建的东西上。更便宜的生成模型解决不了这个问题。
第一步:动笔之前,先把 agent 的调用分拣一遍
挑一个你已经上线的真实 agent 循环,过一遍它发出的每一次模型调用,逐个问三句:
- 有效答案的全集,是你现在就能列出来的吗? 如果真的可能出现无法预见的新答案,这个调用需要生成。别动它。
- 一个人瞟几秒钟,不用推理就能给出同样的答案吗? 如果需要的是真正的斟酌而非辨认,分类器会以同样高的自信给出错答案。
- 这个调用的频次,高到省下毫秒和几厘钱真的能攒出数量吗? 一天一次的决策不值得重构,一天一千次的值得。
三关全过,才是迁出 LLM 的真候选。只要有一个「否」,它就留在原地。
拿具体例子过一遍:判断一条进来的客服工单是否紧急。有效答案就两个词。几乎任何人扫一眼就能定。它在整个客服队列里时刻发生。这就是一个一直被当成「生成」来计费的决策,毫无道理。
第二步:弄清你实际发出去和拿回来的是什么
TypeSafe 把 Jev 归入它称之为 System One 模型 的类别。这个名字致敬判断里快速、靠模式匹配的那一档,与之相对的是生成模型逐步写出答案时的慢而审慎。
接口就照这个分法设计。你发送:
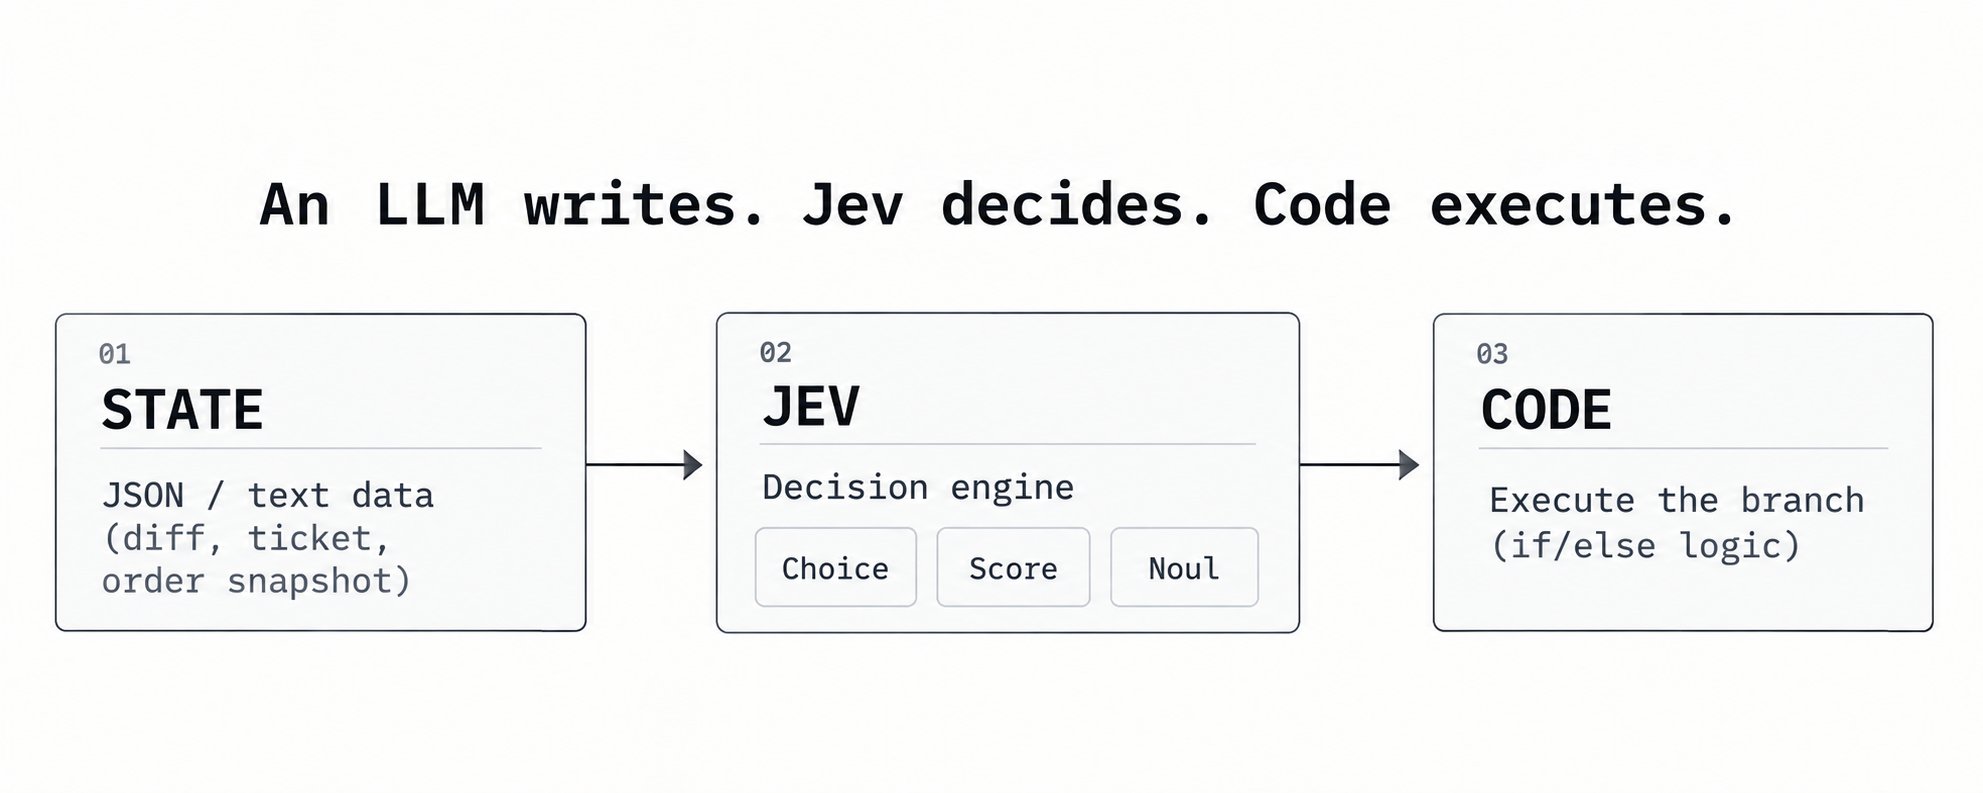
- State(状态):描述当前局面的一切。一个 diff、一张工单、一份订单簿快照,文本或 JSON。
- Questions(问题):你要的判断,有效答案的形状事先定死。
拿回来的是一个带类型、按概率加权的答案。不用从句子里解析任何东西,不用对着模型可能无视的 schema 校验任何东西,也不会因为模型自作聪明冒出计划外的第五个选项。
这个区别值得记住。生成模型把状态变成文本,Jev 把状态变成一个固定结果集上的分布。代码向来能在行数、布尔标志这类可直接计算的东西上分支。它从来没法干净地在「这个改动是否超出了计划描述的范围」上分支,而这个缺口一直由完整 LLM 以远超问题本身的价格填着。
第三步:学会仅有的三种题型
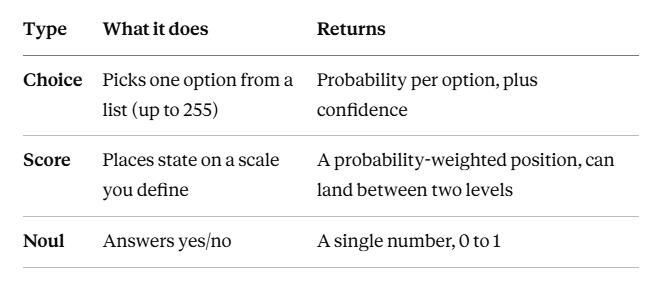
这就是全部接口面。你的 agent 里每一个决策,无论是挑一项、排序还是判是非,都映射到这三者之一。
有个细节能省下一周调试,Jev 从来看不见你的问题 ID。 字段名叫 safe_to_publish 对它没有任何指令作用。真实的要求必须写进 instructions 文本、写进每个选项的描述里。
喂证据,不要喂摘要。「研究员做完了」告诉 Jev 的,远少于研究员实际找到的来源和仍未补上的缺口。
第四步:安装(复制粘贴,五分钟)
装 Python 3.12+,开终端。
macOS / Linux:
mkdir jev-starter && cd jev-starter
python3 -m venv .venv
.venv/bin/python -m pip install --upgrade typesafe-sdk
Windows PowerShell:
mkdir jev-starter
cd jev-starter
py -3 -m venv .venv
.\.venv\Scripts\python.exe -m pip install --upgrade typesafe-sdk
去 TypeSafe 控制台拿一个 key,别让它进源码文件:
export TYPESAFE_API_KEY="your-key"
如果你跑的是编码 agent,把官方 skill 装给它,让它自己写出正确的调用:
npx skills add typesafe-ai/skills --skill typesafe-ai
第五步:写任何应用代码之前,先测一个真实决策
打开 TypeSafe Playground。把这段贴成你的 state:
{
  "ticket": "The deploy failed twice and customers are seeing 500s.",
  "priority_history": "No prior escalations from this customer."
}
加一个 Noul 问题:「这需要立刻处理吗?」再加一个 Choice 问题:「哪个团队该接手?」,给 engineering、billing、sales 三个选项,各配一行说明。
跑。读置信度,不只读标签。然后改 state 里一个字段,再跑一次。看多小的一个改动让分布挪动了多少。这五分钟的测试教给你的,比任何文档都多。
第六步:接上完整决策,带代码
同一个工单分诊,端到端接好、可直接运行:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()  # reads TYPESAFE_API_KEY from the environment

state = {
    "ticket": "The deploy failed twice and customers are seeing 500s.",
    "priority_history": "No prior escalations from this customer.",
}

result = client.system_one(
    state=state,
    questions={
        "urgent": Noul(
            instructions="Does this need attention right now?",
        ),
        "owner": Choice(
            instructions="Which team should handle this?",
            criteria={
                "engineering": "Product failures and outages",
                "billing": "Charges, invoices, and refunds",
                "sales": "Pricing and new accounts",
            },
        ),
        "severity": Score(
            instructions="Rate how severe this issue is.",
            criteria=["Cosmetic", "Minor", "Major", "Critical"],
        ),
    },
)

print(result.answers["urgent"].noul)        # e.g. 0.94
print(result.answers["owner"].choice)       # "engineering"
print(result.answers["owner"].confidence)   # e.g. 0.87
三个问题,一次 API 调用,对着同一份 state 并行评估。这就是第四个、第五个问题几乎不增加延迟的原因。
答案回来之后的一切归你的代码:
if result.answers["urgent"].noul > 0.9 and result.answers["owner"].choice == "engineering":
    page_on_call()
elif result.answers["owner"].confidence < 0.6:
    send_to_human_review()
else:
    add_to_queue(result.answers["owner"].choice)
这一小块就是整个架构的缩影。Jev 回答模糊的问题,代码掌管之后的每一个分支。
第七步:建一扇真正的生产门禁(不是演示)
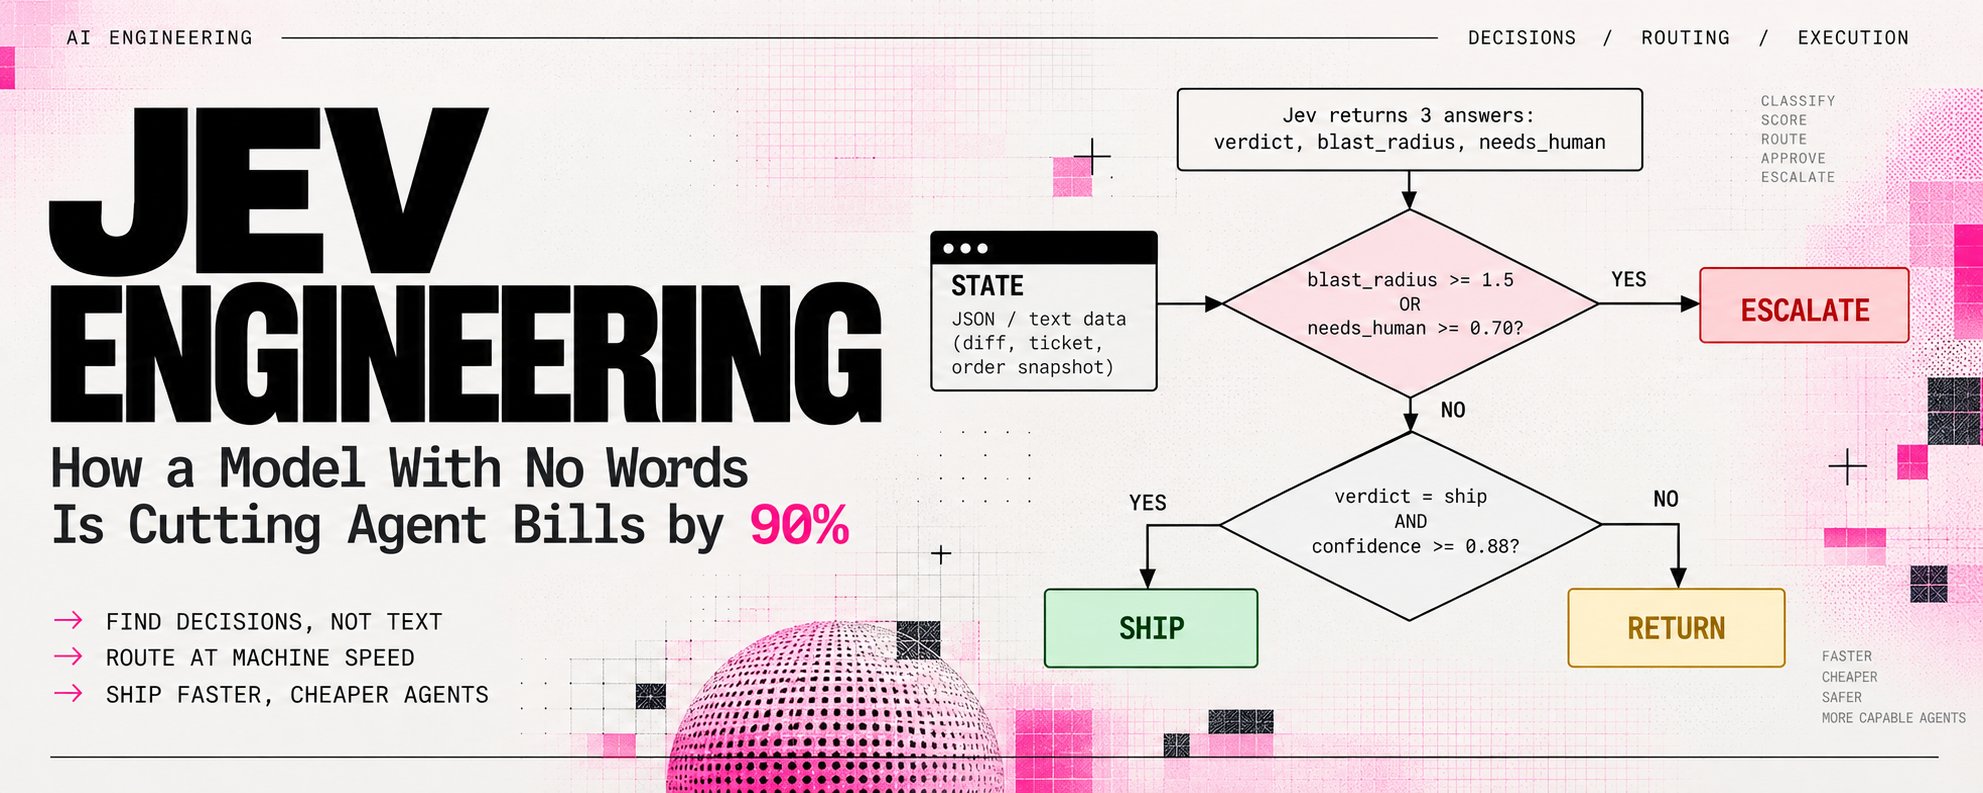
这是会上线的版本:读一个代码 diff,决定 ship、return 还是 escalate。
一切可计算的东西留在代码里。永远不要付钱让模型数数:
def snapshot(diff, plan, test_exit):
    planned = set(plan["paths"])
    touched = set(diff.files)
    return {
        "files_touched": sorted(touched),
        "outside_plan": sorted(touched - planned),
        "lines": {"added": diff.added, "removed": diff.removed},
        "tests": "passed" if test_exit == 0 else "failed",
        "migrations": any(f.startswith("migrations/") for f in touched),
        "plan_said": plan["summary"],
    }
决策本身:
QUESTIONS = {
    "verdict": Choice(
        instructions="What should happen to this change?",
        criteria={
            "ship": "tests pass and the diff stays inside the plan",
            "return": "the diff goes beyond what the plan described",
            "escalate": "irreversible, or touches something unplanned",
        },
    ),
    "blast_radius": Score(
        instructions="How hard would this be to undo?",
        criteria=["one file, revert it", "several files", "data or schema, cannot revert cleanly"],
    ),
    "needs_human": Noul(
        instructions="Should a person read this before it merges?",
    ),
}

with TypeSafeClient(model="jev-1.13.0") as client:
    r = client.system_one(state=snapshot(diff, plan, test_exit), questions=QUESTIONS)

v = r.answers["verdict"]
radius = r.answers["blast_radius"].score
human = r.answers["needs_human"].noul

if radius >= 1.5 or human >= 0.70:
    decision = "escalate"
elif v.choice == "ship" and v.confidence >= 0.88:
    decision = "ship"
else:
    decision = "return"
仔细读最后那个块的顺序。人们就是在这儿出错的。
硬规则先赢:blast radius 的位次高于 verdict,无论 verdict 多有信心。一个模型对「不可逆的东西要不要放行」没有投票权。然后走有把握的路径。剩下的全部落到 return,这是代价最低的失败。
阈值写在代码里,可以在 pull request 里评审。在你有自己的标注样本之前,0.88 只是占位符。
为什么概率而不是标签才是真答案:
{
  "verdict": {
    "choice": "ship",
    "probabilities": {"ship": 0.52, "return": 0.46, "escalate": 0.02},
    "confidence": 0.18
  }
}
ship 技术上赢了。它赢了六个百分点,置信度 0.18。自动合并这个结果是莽撞的,而只看标签你永远不会知道这场竞选拼得这么近。LLM 会写下一句自信满满的「看起来可以发布」,关于比赛有多接近一个字都不会告诉你。

第八步:别再一次只问一个问题
一个请求里的每个问题同时作答、彼此独立。第六个问题不会拖慢响应,只增加它自己那一份 token 成本。
所以一扇门禁不该只问三个问题,该问八个,墙钟时间不变。可以加问碰没碰 auth,加没加依赖,改动行的覆盖率是真是假,commit 信息与 diff 对不对得上。
result = client.system_one(
    state=state,
    questions={
        "next_worker": Choice(instructions="Choose the next step.", criteria={...}),
        "urgency": Score(instructions="Rate request urgency.",
                         labels=["low", "medium", "high", "critical"]),
        "safe_to_run": Noul(instructions="Is this action safe to execute without human review?"),
    },
)
换来这个速度只有一个约束,问题之间读不到彼此的答案。 某个决策依赖一次新搜索的结果,就先跑搜索,第二个请求里再问。
第九步:每一轮都重建菜单
浏览器里可用的操作每次点击后都在变。一个能用的浏览器 agent 每一步都重建一份它真正看得见的控件清单,让 Jev 只从这份清单里选。只有某个字段需要打字时,才让一个小 LLM 顶上。
把你建的任何 router 都照此办理:发此刻在线的 worker,发你当前持有的 source ID 而不是上一轮的。state 一变就刷新选项。
跳过这一步,你的决策模型就是在照着昨天的菜单点菜:挑中一个已经离职的审阅者,或一小时前就删掉的来源。
候选清单太大时,代码先滤掉明显不合的,对剩下的打分,再在短名单里选。Choice 最多吃 255 个选项,但最便宜的选项永远是你根本没发过去的那一个。
第十步:把 harness 加上
有个数字值得坐下来想一想。两套跑同一个模型的设置,据报道在同一任务上分别拿到 78% 和 42% 的准确率,差距完全来自环绕循环的工程方式,与权重无关。编码工具其实早已在闭源 harness 里悄悄内置了一版危险分类门禁,这正是人们开始信任 agent 的很大一部分原因。
这个模式现在对任何人可用:
from langchain.agents import create_agent
from langchain_typesafe.experimental.middleware import AutoModeMiddleware

# checks every tool call before execution
# blocks risky actions, approves safe ones. zero generation tokens spent
guardrail = AutoModeMiddleware(tools=["bash"])
agent = create_agent("openai:gpt-5.6-luna", middleware=[guardrail])
同一思路也能当模型路由器用,决定哪个模型值得被唤醒。
from langchain_typesafe.experimental.middleware import ModelChoice, ModelRouterMiddleware

router = ModelRouterMiddleware(
    choices={
        "fast": ModelChoice(model="openai:luna", criteria="Direct lookups, extraction, localized changes."),
        "powerful": ModelChoice(model="openai:sol", criteria="Architecture and high-stakes decisions."),
    },
    instructions="Choose the least costly model that can complete the task.",
)
agent = create_agent("openai:gpt-5.6-luna", middleware=[router])
两层都不生成一个字,也都不加你会在意的延迟。
早期访问窗口实际产出了什么
让这次发布立住的数字不在公告里。有人把 Jev 接进自己已有的系统并晒出了结果,数字来自他们。
Browser Use 项目的维护者 Gregor Zunic 发布了一段带时间戳的原速录像:一个浏览器 agent 在真实航班搜索的每一步用 Jev 挑下一次点击。总耗时 7 秒,总成本 $0.0039。需要说清它实际做了什么。它检索并比较了结果,没有订票,而且计时从首页加载完成后才开始。
另一批人把 Jev 对准了埋在既有管道里的分类活,比如给研究论文分主题,判断一封来信下一步需要什么,或者给长 agent 会话里的工具调用打分,看哪些值得保留。模式全都一样。这些决策的答案本来就没几种形状,原本要走完整的生成调用,现在成本以美分计。
这些都不是假设。没等教程的人已经拿真实数据跑了第一步里的那类决策,也就是挑选、评分和回答是非。
账单的算术,摊开说
每百万输入 token $0.042,输出免费。按每次决策约 1000 token 算,一万个决策花 42 美分。这一万次是非分叉要是走前沿模型、每次三美分,就要花 $300。
这是算术,不是基准测试。已公布的 20 到 200 倍、40 到 400 倍区间是上限,不是典型结果。它出现在有界决策密集的工作流上,以写作为主的工作流上则不会出现。先审计你自己的 agent。多数 agent 账单贵在多数步骤从来没被要求过便宜,跟活难不难关系不大。
它在哪儿失灵,和赢面一样摊开说
它无法突破你声明的 schema。定义了 ship、return、escalate,它永远不会发明 revert。TypeSafe 管这叫「不会幻觉」,在狭义定义下成立。
它完全可能自信地选错一个合法选项。 类型安全保证形状,不保证判断。一个 schema 合法的错误照样把毁掉生产的改动合并进去。
答案空间没有事先固定时,它也是错误的工具。它不会写,精确算术和日期运算也做不了,还没法凭空提取一个未知值。无关的上下文会让它变差,这和大多数人从 LLM 那里带来的直觉正好相反。
有一条规则凌驾一切,代码已经能正确解决的,留给代码。 永远不要问模型测试过没过。读退出码。
上线,不制造新的故障模式
- 挑一个有界、低风险的决策,每个答案都叫得出名字。
- 先写判据再碰模型:每个选项里该装什么,定义清楚。
- 收集带预期答案的真实样本,包括丑的、含糊的。
- 与现有逻辑并行跑影子模式,先什么都不改。
- 画准确率对置信度的曲线。阈值从你自己的曲线上取,不从博客上取。
- 先自动化最安全的分支。不确定的分支留给人或更强的模型。
- 钉住模型版本。记录每个问题、判据与阈值,任何一次变更都可回放。
允许它拦真实流量之前,影子模式至少跑几天。它跟你的直觉相左的次数会超出预期,而那些分歧多数最后会被证明是你的阈值问题,不是它的判断问题。五分钟的演示里你永远不会发现这个。
这套打法实际给你什么
在你已经建好的某个地方,一位外科医生此刻正在量体温。一个完整的生成模型,安静地回答着是非题,而它从来就不是回答这类题的合适工具。账单只涨不降。
去找出来。修掉它比继续付钱便宜。
写作交给擅长写作的。判断搬到为判断而造的模型上,便宜、快。之后的一切,是你能测试、能回滚的普通代码。
这道分界就是整门手艺,而且一年后无论具体由哪个模型来做判断,这道分界都还在。
打开你自己最近一次 agent 运行。数一数它停下来做选择的地方,它写下了什么先不用管。把每一个都过一遍第一步的三问过滤器。多数 agent 里藏着的这种停顿,比任何人注意到的都多,要等有人专门去找停顿才看得见。