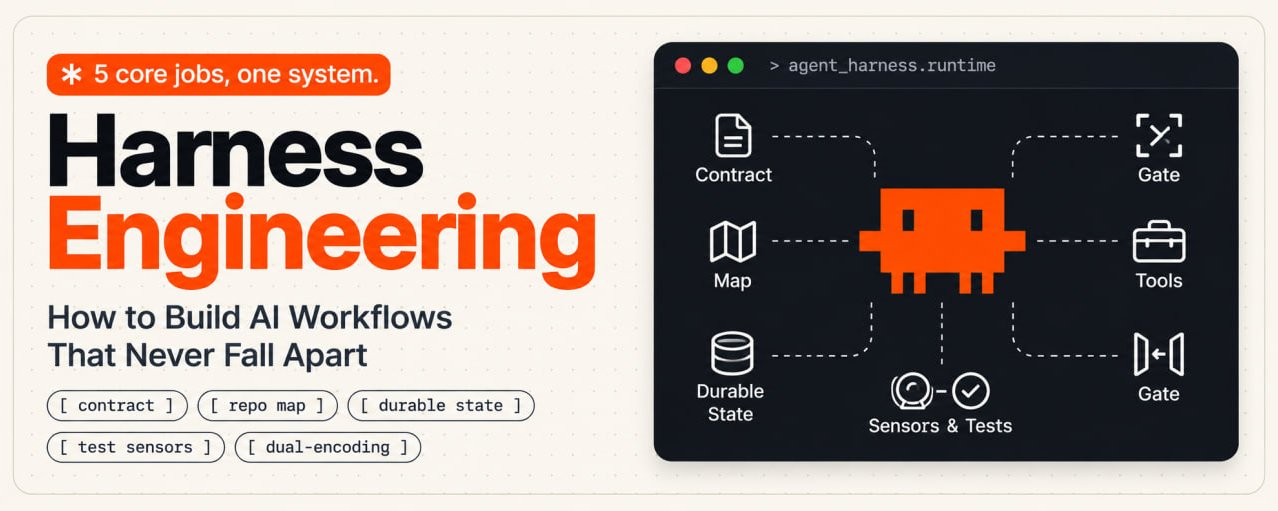
AI 的输出有了问题,多数人的第一反应是改提示词,接着换模型,再接着换更大的上下文窗口。模型照样会忘指令、推荐错工具,验证也跳过,没跑通的活还报告成功。作者的判断是,毛病出在模型权重之外的执行环境里。这层环境叫 harness,设计它就是 harness 工程。提示词工程调整措辞,harness 工程搭建措辞赖以执行的基础设施。
同一个前沿模型,放进空白聊天框,产出的是随手写的散文;放进一个仓库,给它终端权限和自动化测试,再配上项目地图与隔离工作区,它交付的是能跑的软件。权重没变,变的是 harness。OpenAI 在 Codex 上训练 agent 时记录过同样的规律。早期运行失败是因为环境描述不足,团队补上了明确的能力检查和机械边界,没在提示词里要求模型更努力(可参看 OpenAI 的 Harness engineering: leveraging Codex in an agent-first world,2026 年 2 月)。所以 agent 反复失败时,先别去改系统提示词里的形容词,去检查模型周围那套运行环境。
可靠 AI 系统的三层
提示词链和 agent 循环,再加上多 agent 图,常被当成互相竞争的思路。作者把它们看成同一系统里的三层。
harness 层:环境与记忆
模型权重之外的一切都算 harness,包括文件系统访问和环境变量,也包括认证令牌与持久化文件。作者借用 Andrej Karpathy 的类比,模型是 CPU,上下文窗口是内存。一颗没有存储和操作系统的裸 CPU 会立刻崩掉。把二十页背景资料一次塞进提示词,等于把内存灌满,模型对关键规则的注意力随之流失。干净的 harness 把项目知识存在外部 markdown 文件里,每一步只加载当下需要的那一小段。
回路层:证据与收敛
模型产出的代码或文本需要自动验证。追问模型「你确定吗」会形成循环幻觉,它评估的是自己的概率预测,结果是确认最初的偏向。回路层引入客观传感器:
- 测试运行器(pytest、vitest、cargo test)
- 格式校验器(JSON schema 检查、linter)
- 执行预算(最多尝试四次,然后交人复核)
模型提出修正,harness 跑测试并把原始终端输出交回去。只有机械证据确认修复生效,执行才继续。
图层:工作分配
长任务硬塞进一条无尽的对话线程,迟早垮掉。图层把工作分到彼此隔离的执行上下文里。一个 worker 分析任务、写实现蓝图,第二个在隔离的分支目录里写代码,第三个专门挑错,拿项目需求审 diff。每个上下文都保持干净,没有哪条提示词要扛整个项目的生命周期。
个人 harness 的五项职责
做 harness 工程不需要庞大的企业平台。作者把个人日常工作流里的 harness 归结为五条机械规则。
每个请求都写成有边界的契约
对话式提示词允许模型悄悄改写「成功」的定义。含糊的提示词一遇到阻力,模型就去解一道相邻的、更容易的题,然后宣布胜利。生产级契约在生成开始前就划定硬边界:
- 交付物:确切的文件名和格式
- 约束:允许的依赖、风格要求、token 预算
- 非目标:明确列出模型不能碰的东西
- 验收标准:任务关闭所需的确切条件
没有契约,模型自己决定什么时候算完成;有了契约,由验收标准决定。
给地图,不给百科全书
每个前沿模型在长程任务上都会出现上下文退化。把整份项目文档倒进对话,既烧 token 又稀释注意力。更好的做法是在根目录放一份紧凑的地图,写明文档、schema 和源码各在哪里。模型先扫地图,挑出唯一相关的文件,只读那一个。紧凑的地图能保住工作记忆,一次性倒进去的大段提示词会把它耗尽。
把记忆外置到持久文件
聊天记录只是临时草稿区,对话线程当不了数据库。会话一长,注意力衰减,上下文窗口也会填满。架构决策和用户偏好,连同未解决的 bug,应当存进专门的项目文件,在 Claude Code 里是 CLAUDE.md,在 Cursor 里是 .cursorrules。新会话开始时模型读这个文件就能接着干。清空聊天或碰到限流,甚至换了模型,工作都还在。
先装传感器,再放权
agent 修不了它看不见的错误。对模型说「写没有 bug 的代码」什么也改变不了;给它一条命令,返回退出码 0 或一段堆栈,它就有了事实依据。传感器把主观的质量变成可验证的证据:
- 遇到语法错误就失败的编译器和类型检查器
- 验证数据转换的自动化测试脚本
- 确认必填字段齐全的清单校验器
模型产出制品,传感器生成证据,harness 判断这次运行过不过。
双重编码
规则只用自然语言写一遍,就留下了概率性失效的空间。模型读到这条指令,又要处理另外二十条约束,负载一高就把它跳过去了。双重编码的做法分两步,先用文字解释规则,让模型理解目标;再放一道机械闸门,规则一破就阻断执行。比如 agent 不许删文件,就在提示词里告诉它,同时收紧它的终端权限,让 rm -rf 直接报操作系统错误。提示词引导意图,机械闸门保护系统。
五分钟搭一个微型 harness
下面这份结构可以放进任何仓库、Claude Project 或 Cursor 工作区。保存为项目根目录下的 HARNESS.md:
# Project Operating Contract

## Operating Boundaries
- Allowed scope: Modify only files explicitly assigned in the current task
- Forbidden actions: Never delete existing tests, never add unverified dependencies

## Project Map
- /src: Application source code
- /tests: Validation test suites
- /docs/decisions.md: Durable log of accepted architectural choices

## Verification Protocol
Before marking any task complete, run these checks in order:
1. Run local linter: `npm run lint`
2. Run test suite: `npm test`
3. Verify output format matches the requested schema

## Failure Escalation
If a test fails twice on the same error:
- Stop autonomous editing
- Print the exact error log
- State the proposed fix and wait for user confirmation
这份短文件能替掉每次对话里反复敲的二十行提示词。它划定项目范围,管住文件访问,并强制做机械验证。按双重编码的要求,其中的禁止项最好再落到权限配置或 hook 上,光写在文件里只算第一层编码。
两遍式提示
在普通聊天界面里处理难的推理任务,可以用一个两遍的 harness 回路。多数人要一个答案,收下第一稿就完事;生产工作流把生成和批评拆成两遍。
第一遍是执行:
Draft the technical specification for [Feature X].
Follow the constraints listed in HARNESS.md.
Do not evaluate your own output yet.
Output the raw draft and state all assumptions made.
第二遍是对抗式审查:
Review the draft above as a skeptical senior reviewer.
Check against these specific failure points:
1. Are edge cases handled when input arrays are empty?
2. Does the logic introduce extra dependencies?
3. Does the solution violate any constraint from HARNESS.md?

List every failure point found.
Then output the revised version fixing those gaps.
作者认为把创作者和审查者的角色分开,能把幻觉式断言砍掉一半,理由是模型被明确要求攻击自己的错误时,就没法再为它们辩护。这个「一半」原文没有给出数据来源。两遍仍在同一个上下文里进行时,审查者看得到第一遍的全部推理,独立性有限;条件允许的话,第二遍放进新会话或单独的 subagent 更接近上面图层说的对抗式审查。
harness 的价值会累积
模型每隔几个月就更新一次,今天好用的提示词,到下一个模型版本上常常输出不同。新模型发布时提示词也许要小改,测试套件和项目地图,连同权限边界、持久状态文件,都原封不动,换上新模型马上能用。模型提供的是原始算力,harness 提供的是把算力变成可靠执行的轨道。