我本来没打算学图工程。我只是不想再当一个保姆,守着一个每二十分钟就忘了自己在干什么的 agent。
一个 agent,一段长对话,一次一个任务。让它做点真正的事——跨十几个文件的重构、一轮调研,任何超过五分钟的活——到第二十分钟左右它就开始漂。修好一个文件,悄悄弄坏另一个。忘掉它第三分钟做过的决定。我重启它,它从零开始,好像刚才那二十分钟从没发生过。
起初我一直在怪模型。回头看,模型通常不是真正的问题,至少不是我以为的那种。我只是还没学会那个后来贯穿我每一次修复的东西:我一直在找犯罪现场。我需要找的是罪行。
没人提醒过我的形状
我把所有东西都跑成一条线。第一步,然后第二步,然后第三步,每一步都客客气气地等上一步,哪怕根本没有等的理由。
我是在测一件不相干的事时发现的。我写了一个任务:「从这个源拉取前三条标题,然后检查我域名的 SSL 证书这个月是否到期。」两件毫无关系的事,仅仅因为我按这个顺序敲进去就被串了起来。证书检查一条标题都没打开过。它坐在那儿,等一个根本不存在的依赖。
于是我开始对自己工作流里的每一个「然后」问同一个问题:这一步真的需要上一步的结果吗?需要,等待是真的,保住顺序。不需要,那我一直在一条只因措辞而存在的队列上烧时间。
我几乎在每个做过的东西里都找到了两三个这样的假等待。每一个都是白白扔掉的时间。错误从不在步骤里。错误在我围着步骤画的那条线上。
我实际在看的是什么
把工作流画出来而不是只跑一遍之后,我意识到那条直线其实已经是一个图了。只是最糟的那种:一条链,每步严格一个进一个出。它能跑。它零冗余。第三步一停,第四步永远不发生,第一步已经弄明白的东西就困在那儿。
两个真实的部件,一旦想通,词汇就再不需要了。节点(node)干实际的活,一个有边界的任务,一个 agent,一个输入,一个输出。一个节点干两件事的那一秒,我就没法并行它、没法单独验证它、坏了也没法调试它。边(edge)只是「有真实的东西从一个节点跨到了下一个」的证据,仅此而已。
一个节点在我给它契约的那一刻变得可用——固定的进出形状,由 schema 强制,而不是指望模型返回我能解析的东西:
const ITEM = {
  type: 'object',
  properties: {
    title:  { type: 'string' },
    url:    { type: 'string' },
    impact: { type: 'string', enum: ['high', 'medium', 'low'] },
  },
  required: ['title', 'url', 'impact'],
};

const result = await agent(source.prompt, {
  label: `research:${source.key}`,
  schema: ITEM,
  agentType: 'general-purpose',
});
在这之前,我读自由文本,猜下一步能不能用。之后,我有了一个真正信得过的形状。
第一个提速,和模型毫无关系
我重画了一个真实的工作流,四十来步,全串成一条线。逐个箭头过,问那个假边问题。大多数活了下来——它们真的是串行的。但有一打不是。一直在无理由等待的工作。
砍掉假边,让独立的部分同时跑,同样的四十步以最慢真实依赖链的速度完成,而不是所有步骤从头到尾叠加的总和。不是更聪明的模型。不是更好的 prompt。只是我画的形状。
反复出现的那个模式有个值得记住的名字:扇出、归并、综合(fan out, reduce, synthesize)。
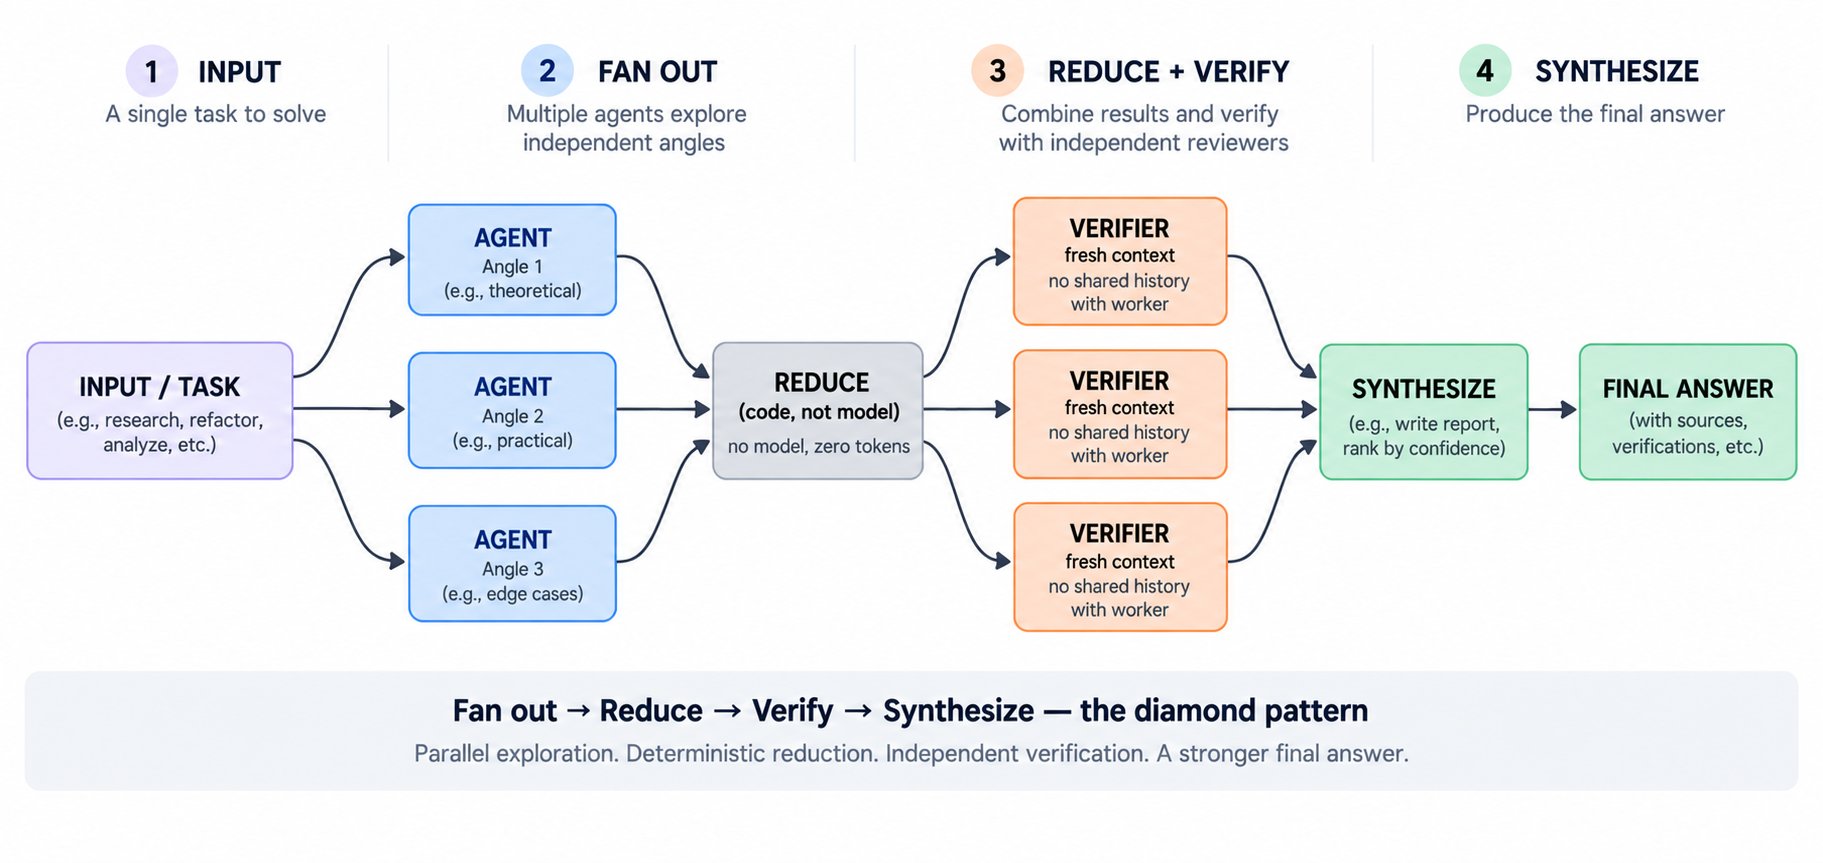
// FAN OUT — independent angles, all at once
const raw = await parallel(
  angles.map(a => () => agent({
    task: `research: ${a}. every claim needs a source url and date.`,
    schema: Finding,
    model: 'cheap',
  }))
);

// REDUCE — plain code, zero model tokens
const findings = dedupeBySource(raw.flat().filter(Boolean));

// VERIFY — a fresh skeptic per finding
const survivors = await parallel(
  findings.map(f => () => agent({
    task: 'try to disprove this. return keep or drop and why.',
    input: f,
    freshContext: true,
    model: 'strong',
  }))
).then(v => findings.filter((_, i) => v[i].verdict === 'keep'));

// SYNTHESIZE — one final agent writes the answer
return agent({
  task: 'one report, ranked by confidence, sources attached.',
  input: survivors,
  model: 'strong',
});
归并就是普通 JavaScript。摊平、去重、过滤,确定性、瞬时、免费。我一直在付钱让模型干一个 Set 就能白干的管道活。又一个犯罪现场,又一个 agent 站在旁边。罪行是一行我懒得写的代码。
真正吓到我的错误
从这里开始,问题不再是速度,是信任。
我建过一个扇出,每个 worker 在继续之前自查自己的输出。看起来完工了。数字看起来干净。然后我读到一篇让我胃里发紧的论文:模型识别自己文字的比率远高于随机猜测,而单是这种识别就会可测地把它们推向偏好自己写下的文本(Panickssery 等,NeurIPS 2024)。另一项研究给这个趋向定了量:让模型当裁判给一组答案打分、其中包含它自己的答案时,GPT-4 给自己输出的胜率高 10%,Claude 高 25%(Zheng 等,NeurIPS 2023)。
我让干活的那只 agent 同时给活打分。它不是在对我撒谎。它真的看不见自己的盲区,因为盲区正在打分。
所以我把它拆开。边上一个独立节点,只干一件事:在发现流向下游之前试着杀掉它。活下来就通过。活不下来,当场死掉。
我第一次做错的细节:验证器需要完全干净的上下文。我把 worker 用过的同一段对话喂给了它。它对一切都点头,当然点头——它已经看过那段推理,早就被预设成接受了。与 worker 共享上下文的验证器什么都没在检查。它只是用另一种字体对自己点头附和。
const verdicts = await parallel(
  ['correctness', 'recency', 'source-validity'].map(lens => () =>
    agent({
      task: `judge this finding via ${lens}. return keep or drop.`,
      input: finding,
      freshContext: true,
      schema: { verdict: { enum: ['keep', 'drop'] } },
    })
  )
);
干净上下文,三个镜头,多数同意才算数。这是唯一真正抓到过东西的版本。犯罪现场是那个坏成绩。罪行是让同一只手握着论文和评分两支笔。
修完之后还活着的陷阱
我以为完事了。然后我建了个更精细的东西——配对验证器、一个审计节点查另一个审计节点——然后发现审计在拿自己的数字对照一份报告,而那份报告来自同一个底层源头。
所有东西都和所有其他东西一致。没有任何东西被真正验证过。它会和我最初的单 agent 循环一模一样地失败,只是更晚、更贵、坠落路上亮起更多绿色对勾。
我需要的是一个锚点,一个真的没法跟它争的东西。一个跑起来并且真的通过的测试,而不是模型说它应该通过。一个落进真实账户的数字。一小把被我完全冻结的规则——恰恰因为那些是一个优化器最想悄悄削弱来「显得在赢」的规则。一张图最诚实的部分,是它里面拒绝移动的那些部件。
这次我故意把它弄坏的地方
工作扇得再宽一点,我撞上了所有人都会撞的失败:多个 agent 同时写同一批文件,互相安静地覆盖。我抓到它只是因为同一次运行的两个「已完成」输出互相矛盾。
修复是一句冻进每个 worker 指令里的话:
Never git stash. Never git reset.
No git command except committing a specific file.
然后我把这支舰队按 git worktree 分片,隔离的副本,每组只碰自己的。四个 worktree、每个十六个 agent,代替六十四份独立检出,再没人踩别人的文件。
那不是我把扇子扇宽后弄坏它的最后一种方式。下一个花更久才注意到,因为它看起来不像崩溃。我扫了大约一千个文件,把一千份原始结果全部喂进同一个最终综合步骤,然后看着它安静地失败——没有报错,只是答案随着范围变宽越来越差、越来越虚。我在综合步骤有机会真正消化任何东西之前,就一头冲爆了上下文窗口。
修复是给扇入分层,而不是全倒进一个步骤。原始结果分批、每批单独摘要、再从摘要做综合,永远不碰原始堆:
const batches = chunk(results, 40);
const summaries = await parallel(
  batches.map(b => () => agent({ task: 'summarize this batch', input: b }))
);
return agent({ task: 'write the answer from the summaries', input: summaries });
最终步骤现在读二十五份摘要而不是一千条原始条目,答案不再随着规模变宽而变差。犯罪现场是一个没有任何报错可指的、悄悄退化的答案。罪行是要求一个节点一次抱住全部,而从来没有任何东西被造出来抱那么多。
我差点没建的路由器
有段时间每条发现都走一模一样的全量审计,不管需不需要。一行错别字修复和一笔碰到支付逻辑的改动走同样的三镜头验证。那种浪费在我说清楚为什么之前,就先在账单上感觉到了。
修复是一个路由节点,一次小小的分类调用,决定剩下的工作走哪条路:
const { severity } = await agent(
  `Classify this diff's risk:\n${diff}`,
  { schema: { properties: { severity: { enum: ['low', 'high'] } } } }
);

let review;
if (severity === 'high') {
  review = await parallel(FILES.map(f => () => agent(`Audit ${f}`)));
} else {
  review = await agent(`Quick review of ${diff}`);
}
分类本身仍来自模型。路由不是。严重度一旦定下,走哪个分支是纯代码——同样的输入,永远同一个分支。我不再偶尔惊见 agent 悄悄跳过一次它本该跑的审计,因为那样的跳过必须直接写进图里,而它不在。
然后我注意到另一件事。我一直让最贵的模型跑每一个节点——无聊的分类调用和真正的判断调用,全都一个价。拆开之后简单得几乎不好意思:
claude -p "..." --model sonnet   // repetitive, high-volume nodes
claude -p "..." --model opus     // the reviewer, and anything writing rules
这里的犯罪现场是一张贵得莫名其妙的账单。罪行是一个出于习惯从来没调过的设置,挂在每一个节点上。
检查和模型有同样的毛病,我付过一次钱才看见。快检查,几秒内返回的,属于循环内部,贴着它检查的活放。慢检查,要跑几分钟的,不属于——每个节点后面都跑一遍,等于为跑一次就够的东西付几百次钱:
# fast check, inline
claude -p "..." && ./scripts/judge.sh "output/$name" || echo "$name" >> logs/failed.txt

# slow check, once, at the end, grouped into categories instead of a flat list
./scripts/expensive_check.sh > logs/errors.txt
sort logs/errors.txt | uniq -c | sort -rn | head -20
最后那行比我第一次用时预想的重要。把错误按类别分组而不是当一个平铺列表读,把看起来四百个独立问题变成了六个真实原因。我不是在修四百个犯罪现场。我在修六桩罪行,而计数一直在骗我。
连工作有多大都不知道的时候
有些活没法提前规划。一次 bug 排查,找到一个 bug 又翻出三个。总量要到身在其中才知道,这需要环——一条指回更早节点的受控的边。环默认是危险的。一个不收敛的环就是一个趁我不注意悄悄烧光我全部预算的死循环。
真正收敛的版本是「挖到干」(loop-until-dry):持续派发查找器,直到连续几轮一无所获,停。我第一次建它就做错了,错得足够微妙,花了整整一天才看出循环为什么永远不干。
const seen = new Set();
const confirmed = [];
let dry = 0;

while (dry < 2) {
  const found = (await parallel(
    FINDERS.map(f => () => agent(f.prompt, { schema: BUGS }))
  )).filter(Boolean).flatMap(r => r.bugs);

  const fresh = found.filter(b => !seen.has(key(b)));
  fresh.forEach(b => seen.add(key(b)));

  if (!fresh.length) { dry++; continue; }
  dry = 0;

  const verified = await parallel(fresh.map(b => () =>
    agent(`is this real: ${b.desc}`, { schema: VERDICT })
  ));
  confirmed.push(...verified.filter(v => v.real).map((v, i) => fresh[i]));
}
我第一次错在这儿:我只在一条发现通过第二次干涸检查之后才为它调用 seen.add(),而不是在它被找到的那一刻。这意味着一个查找器可以连续两轮返回一模一样的结果,在它被标记 seen 之前,每一轮都被当成新的。干涸计数器不断被空欢喜清零,循环多跑了三倍时长,直到我注意到同一小撮结果一轮轮轮回,每轮都伪装成新的。
修复是把一行挪到对的位置:对循环见过的一切去重,确认与否无关,找到即标记,而不是裁决之后。我现在同时压三个停止条件出厂——连续干涸轮数、硬性 token 预算、最大迭代数——因为单独任何一个都是我已经掉过的陷阱。
犯罪现场是同一个 bug 走进来两次。罪行是一行从来没锁门的代码。
拦住我浪费一个周末的数学
把这些放大之前,我强迫自己做了一道一直在逃的计算。十六个 agent 并行买不来十六倍速度。Amdahl 定律给出真实数字,而且它让人清醒:
S = 1 / ((1 − p) + p/N)

p = the fraction of the work that's genuinely independent
N = number of agents

p = 0.95, N = 16  →  ×9.14   (not ×16)
p = 0.70, N = 16  →  ×2.91
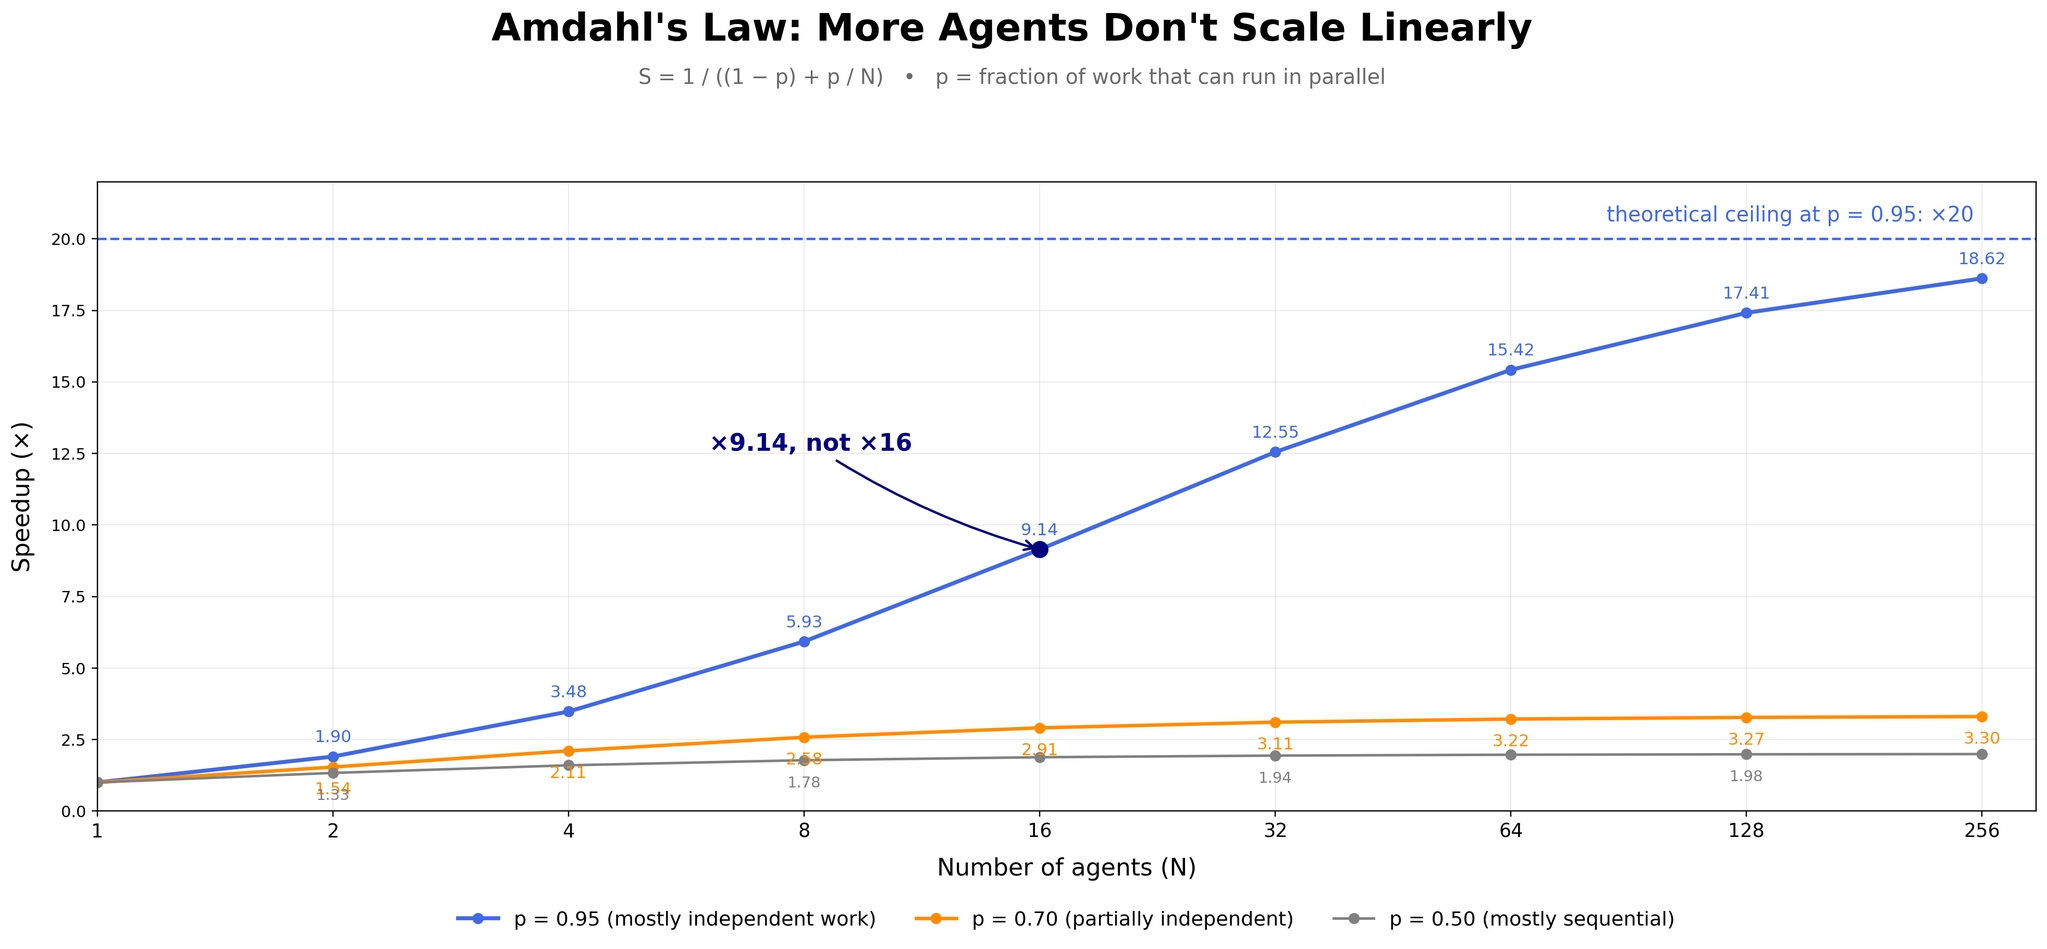
95% 独立工作的前提下,十六个 agent 给我大约九倍速度,不是十六倍。我一直在按错误的数字做预算,而它本会先变成一张令人困惑的账单,再变成一课。串行占比——最终归并、验证那一遍、每一条真实的边——封死了扇出永远帮不到的地方。最开始那个假边测试,成了我一分钱不花就估出 p 的办法。
我最终信得过的构建:磁盘优先
跑超过一小时的东西,不再活在对话里,活在磁盘上,因为运行三小时后的崩溃曾经意味着从头再来。
我先建裁判,再碰真正的活。不是我读输出。一个脚本:
#!/bin/bash
# judge.sh <file>
FILE=$1
[ -s "$FILE" ] || { echo "FAIL: empty"; exit 1; }
grep -q "required_section" "$FILE" || { echo "FAIL: missing section"; exit 1; }
echo "PASS"; exit 0
然后我故意把它弄坏,才敢用它管任何事:
cp output/known_good.md /tmp/broken.md
sed -i 's/required_section//' /tmp/broken.md
./scripts/judge.sh /tmp/broken.md        # must print FAIL
如果故意弄坏的文件通过了,裁判是瞎的,之后每一个绿色结果都一文不值。接下来是规则书,我大声说过一遍的每一处含糊都变成书里的一句话,而且我严守一条:绝不手工补输出让它符合规则书本该说的。那一刻一旦发生,我就有了两个真相源,而其中一个只存在我脑子里。
队列整个活在磁盘上:
#!/bin/bash
# queue.sh — rebuilds from the filesystem every run
for f in source/*.md; do
  name=$(basename "$f")
  [ -f "output/$name" ] || echo "$f"
done
进程跑到百分之六十杀掉,重启,它从百分之六十继续,因为文件系统记得。没有上下文窗口要重建,没有「我们刚才到哪儿了」。
评审跑两趟完全独立的 pass,永不共享上下文:
#!/bin/bash
# review.sh <file>
FILE=$1
for n in 1 2; do
  claude -p "Read rules/rulebook.md. Review $FILE against those rules only. \
For each problem output: RULE: <the rule violated> | ISSUE: <what is wrong>. \
If nothing violates a rule, output PASS." > logs/review_$n.txt
done
强制每条发现引用规则,比我预想的重要。一句含糊的抱怨变成一行可修的东西。同一条规则横跨三个文件被引用时,那不是三个问题,是一条写坏的规则。我重写那一行,重跑整批。
三个犯罪现场,同一副笔迹。罪行从来不在文件里。它是规则书里一句没写出来的话。
这到底花了什么,又买到了什么
这些没有一样是免费的。一支把这套机器投入实战的团队重写了一个生产级 JavaScript 运行时——大约 53.5 万行一种语言变成超百万行另一种语言——用时约十一天。手工做,接近一年。大约五十个工作流,同时最多六十四个 agent,约 16.5 万美元使用费。一个真实的人设计它、盯着它、抓它漏掉的。它也招来真实的公开批评:这么多 AI 生成的代码到底能不能被安全评审。
这是诚实的上限,不是集锦。我自己第一次跑封顶二十项,读完使用报告才碰第二批。每次三问:扇出找到单个 agent 真找不到的东西了吗?验证器抓到 worker 漏掉的东西了吗?结果配得上成本吗?三问全成才翻倍。二十项上赚得回成本的图,两百项上也赚得回。赚不回的,两千项上也赚不回,只是多花一百倍的钱来证明这一点。
我会完全跳过的场景
小活我仍然不碰这套。一个函数、一个孤立修复,协调开销超过单个 agent 单干。想亲自批准每一步时跳过,因为图的全部意义就是不看着我也能铺开跑。探索性的东西跳过——还不知道自己在找什么的时候,一个可操纵的单 agent 能找到我永远画不出来的路径,过早锁死图的形状只是把我错误的初稿锁死。
征兆永远是同一个假边测试。工作里找不到任何真实独立性,就没有值得建的图。它是个环,而对那种活,环刚好是对的。
我真正改变了想法的地方
我以前以为,agent 弄错东西时,修复就是进去把输出手工改对。三个文件犯同一个错,我就修三个文件。
这是反的,而我花了久得丢人的时间才看清。我一直一个一个地解决犯罪现场,从没问过一句:是谁在一遍遍犯同一桩罪。修掉让它发生的那一句话,重新生成整批,下一次罪行无处可藏——以前可藏的只有现场。
我有时仍然把活排成一条线,当工作真的是串行的时候。但对其他一切,我不再要求 agent 连着做更多步。我开始问:真正的分叉在哪,真正的汇合在哪。这个问题才是可扩展的那个。线从来不是天花板。它只是我伸手抓到的第一个形状,因为它匹配我打字的方式——看清这一点之后,连这个习惯也赖不到模型头上了。