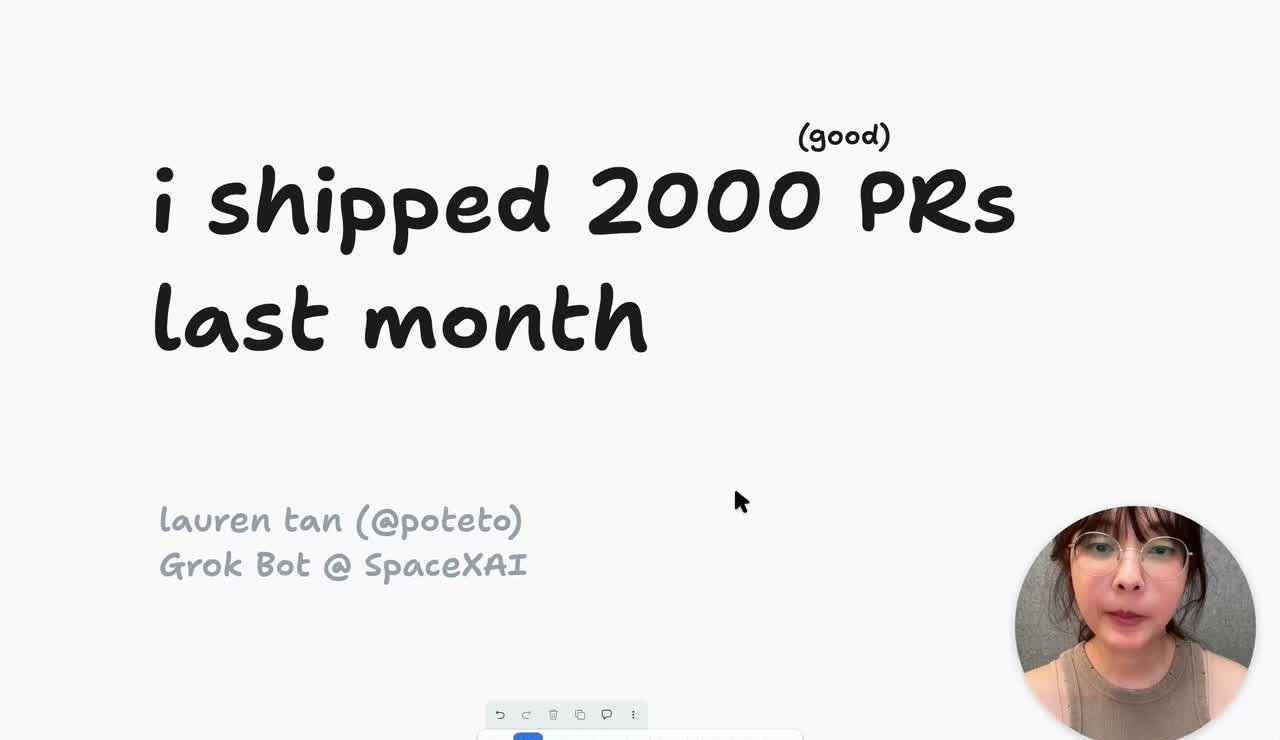
Lauren Tan(X 上的 @poteto)在 2026 年 9 月发了一段 38 分钟的视频,讲怎样把更多 agent 放进生产流程。X 帖子写「上月上线 2,500 个 PR」,视频开场说的是 2,000 个——口径先说清楚:数字是作者自述,公开材料没有第三方审计,不适合当任何团队的绩效基准。真正值得看的问题是:当人不在每个对话旁边时,怎样还敢让 agent 并行工作?本文作者的结论是一条信任链:验证把「完成」变成证据,架构把修改范围变成边界,代码库把每次纠错留下来,外部事件再把新问题送回这条链。并行度只是最后拧大的旋钮。
并行度是信任的结果
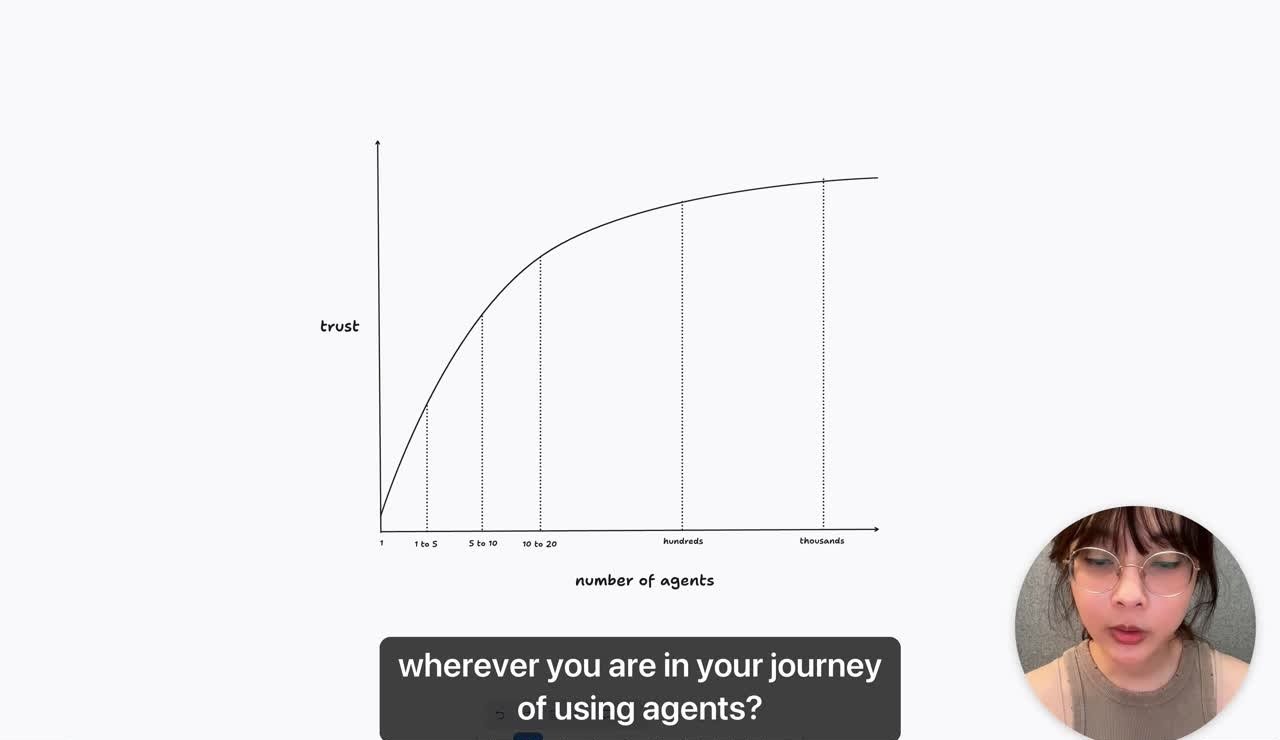
作者画了一条信任曲线:横轴是同时运行的 agent 数量,从 1 到 1–5、5–10、10–20,再到数百数千。起步阶段她形容为「陪跑」——每个对话都要盯着,人一离开 agent 就可能停住或走错。困难不在多开窗口,在于不知道哪个结果可以直接接收;没有这份信任,启动 100 个 agent 只会同时得到更多低质量改动与回归。
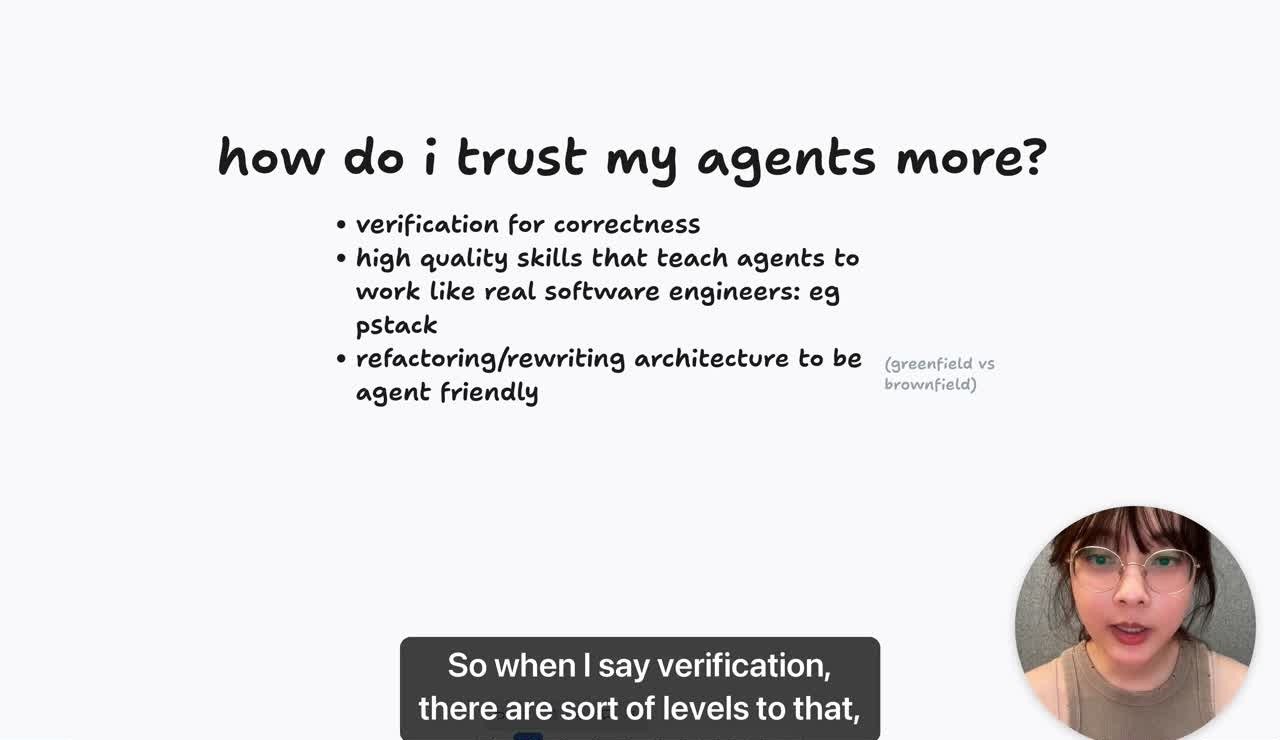
所以验证放在信任曲线前面。顺序是:先让一个 agent 学会运行应用,再让它收集运行证据,然后才扩大到多个 agent——每一档并行度都由上一档的证据支撑。第一步从来不是「多开几个」,而是找出一个人能检查、机器也能重复的完成条件。pstack 的验证指南给了对照表:改 CLI 就跑真实命令,改界面就在运行中的应用里走一遍改动的流程,改性能就比较前后 profile。
验证不是最后跑一下测试
作者把 verification 说成一条连续谱:低端是 verification skill——教 agent 启动应用、通过 Chrome DevTools Protocol 调试、抓性能 trace 和 heap snapshot;高端是 Lean、TLA+ 形式化方法。多数团队不必从形式化开始,一个可靠的运行检查已经能带来很大帮助。
她在 Cursor 做的 Control Glass 有两个关键部件:一个 CLI,用固定命令运行应用、收集 trace、检查性能门槛;一张 feature map,记录用户怎样到达各个功能、用哪个快捷键、点哪些 DOM 元素。两者放在同一个 skill 里——agent 先能稳定控制应用,再能理解一条模糊的用户反馈:只给一张局部截图加三个问号,它也有机会定位到正确的功能。
一个重要区分:验证回答「功能做对了吗」,不回答「代码是否好维护」。后者由她的 pstack 插件(一组 skills 和 playbooks)补上工程习惯。两层叠起来才同时覆盖正确性与质量。pstack 文档里有句很硬的话:「It compiles」 is not evidence——编译通过不能代替检查真实产物。
pstack 的交付流程更进一步:判断改动的 agent 不能是写改动的那个。按指南可以整理成四步:先写完成条件,每条都能由命令或操作检查;让实现 agent 保存检查结果与失败原因;让另一个新 agent 复核改动,不沿用作者的判断;连续一段改动都拿到证据,才进合并流程。这把评审从看感觉变成看证据。
架构要让正确路径更短
验证只能检查结果,不能替你消除混乱的边界。作者因此把 agent-friendly architecture 称为最重要的投资之一。她的观察很直接:语言模型会优先复制上下文里已有的模式,它打开哪些文件、哪些模式就进入上下文,它不会在每个 PR 里重新设计系统。
团队于是有得选:让 agent 在一堆例外里猜,或者把功能放在固定位置、规定模块依赖、限制跨层调用,让正确的入口成为最短路径。Dune 是她团队为 GrokBot 搭的框架,例子是 Electron 主进程与渲染进程的边界——主进程代码不能随便进入渲染进程,保住 60fps 的 16 毫秒(或 120fps 的 8 毫秒)帧预算。这不是为了让人类写代码更自由;目标是让上下文很少的 agent 也能默认做对——产品经理、设计师甚至 CEO 都可能直接进代码库提交功能,架构得替他们挡住明显的错路。
代码库会记住每次 workaround
作者用了一个很形象的比喻:第一次 workaround 像花园里的一株小植物,下一次 agent 看到它就会复制到别处,复制越多下一次复制越容易,几周后临时补丁变成默认模式。注释也有同样效果——人类留注释是为记录边界,agent 却可能把「解释临时绕过」的注释当成不解决根因的理由,继续加一层胶布。
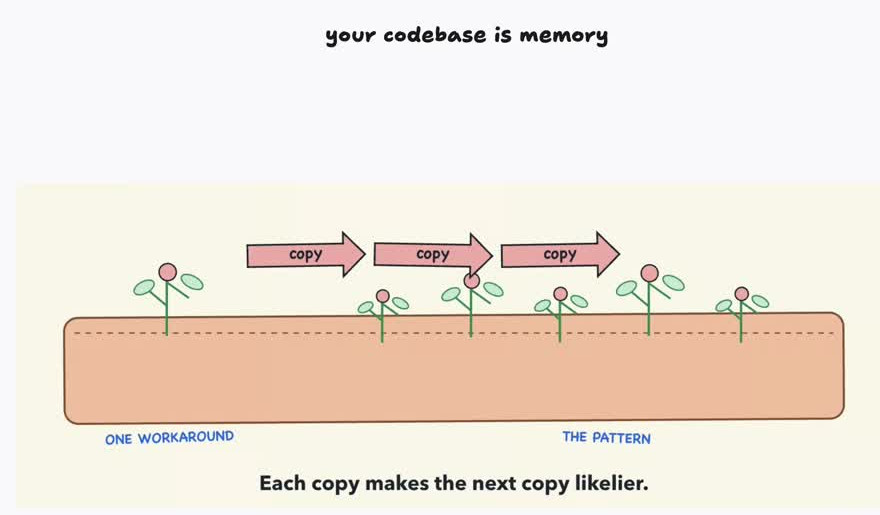
她团队在 Dune 里干脆禁止写注释。看起来严厉,目的不是惩罚写注释的人,而是阻止反模式变成可复制的上下文——这是他们针对自己代码库的选择,不是通用规则。
这改变了评审的问题。评审者不只问「这次改动能不能过」,还要问:如果下一个 agent 照抄这段,我愿意吗? 不愿意,就把纠正写到更高层。作者给的顺序:先改 codebase 和数据结构;做不到,加静态分析、编译器诊断或 CI;再往上是 rules、BugBot 和 skills;style guide 放最后,因为它最依赖人记住并执行。一次纠正只影响当前对话,一条 lint 影响之后每一次运行,一次架构重构让错误路径直接消失。
园丁守住一条 paved path
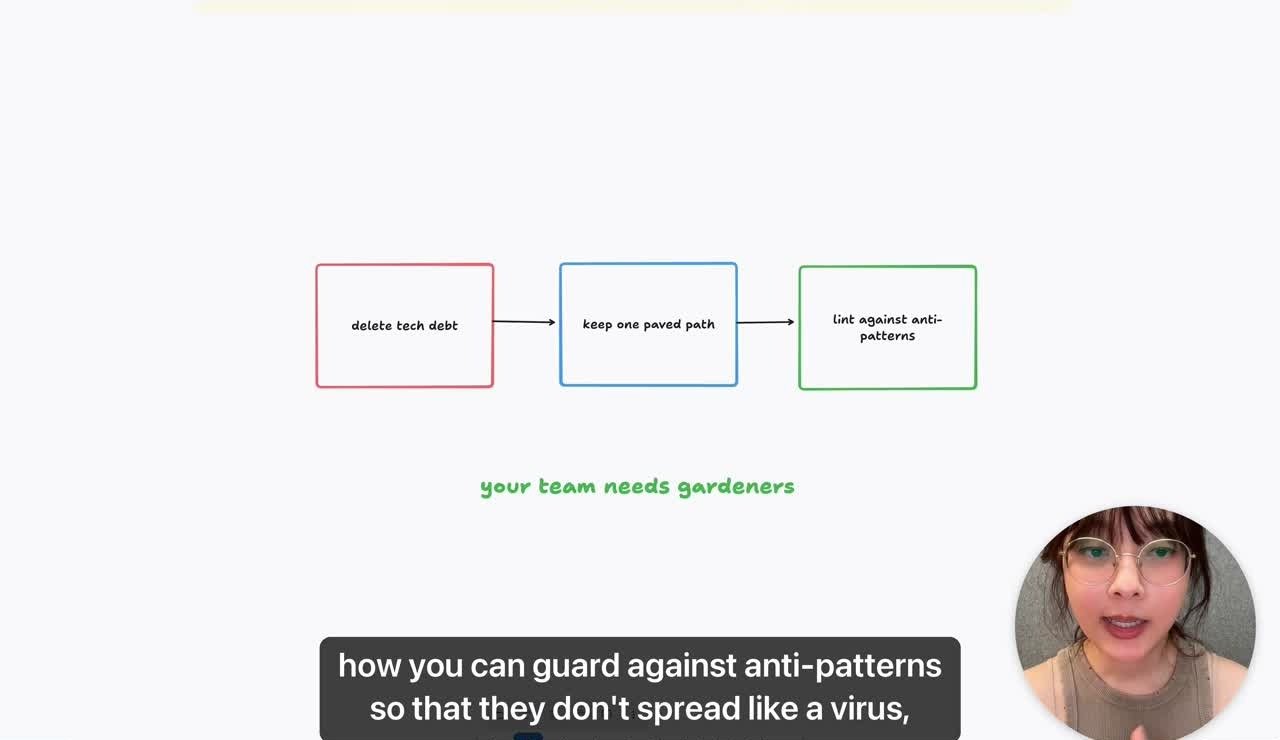
agent 数量上去后,团队需要一个持续维护代码环境的角色——她叫它 gardener。Dune 的三条核心原则就是园丁的日常:删除已存在的技术债;为常见问题保留一条 paved path,让 agent 不必猜有几种写法;为坏模式写 lint,先止住扩散再安排清理。三件事形成循环:清理让示例变好,单一路径让新改动更一致,lint 让下一次错误直接暴露。环境越稳定,验证越容易,能安全并行的范围越大。
pstack 把这套思路包装成可调用的 playbooks——README 说目标是 write less, but higher quality code,仓库列了 23 个 playbooks,覆盖调查、功能开发、修 bug、性能、长时间自主运行、盯 PR 与独立验证后合并。价值不在数量,在于把团队经验从口头评审里抽出来,放进每次 agent 都能读取执行的工作流。
外循环把线上问题送回来
outer loop 让 GrokBot 连接 Slack、Datadog、Sentry、PlanetScale 等服务,线上告警与用户反馈进入后自动启动 cloud agents——Cursor 团队已在跑的自动化包括自动复现 bug 报告、自动打开 PR。关键不是 bot「自己做决定」,而是让事件有固定入口、产出经过同一条证据链。内循环解决一个任务,外循环持续收集线上信号,代码库、静态分析和技能再把这些信号固化。没有前面的约束,外循环只会加速制造 PR。
从一个小闭环开始
这套方法不要求马上搭一座软件工厂,可以先做最小闭环:挑一个经常返工的流程(支付按钮、数据迁移、一条 CLI 命令),写出真实完成条件,每条配一个可重复的检查;把检查包装成固定入口——能启动应用、执行操作、保存证据、失败时给原因;为这个功能写一张 feature map;按 pstack 的做法让独立 agent 复核一次,复核者只看任务、改动和证据;最后,把重复出现的纠正上移——能改架构就不只写说明,能写 lint 就不只提醒。
容易误解的三件事
其一,PR 数量不是质量指标——2,500 与 2,000 的口径差异已经说明问题,即使数字准确,也不知道 PR 大小、合并率、回滚率与维护成本,更好的指标是经过验证、持续存活的改动。其二,验证不是让 agent 免于负责——人仍对最终结果负责,验证只是把责任变成可检查的证据。其三,agent-friendly 的代价要自己算——作者明说理想 agent 代码库锁得很死、人类写起来「很烦」,她认为值得,各团队自己判断。
先把纠错写进系统
这段视频最值得记住的不是「一个人上月发了多少 PR」,而是一个顺序:先让代码库和架构消除错误路径,再用静态分析和 CI 强制边界,接着用 rules、BugBot 和 skills 传递判断,最后才把剩下的选择交给 style guide 和人工评审。
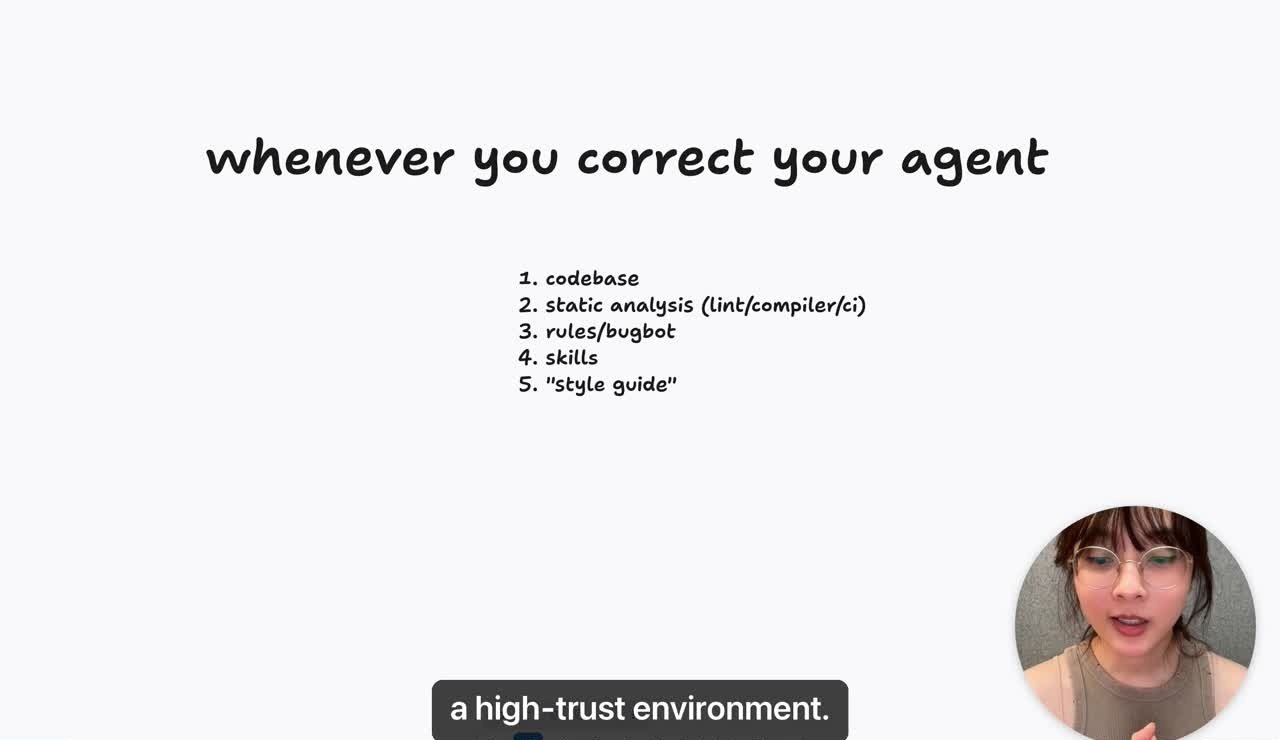
当 agent 犯错,团队可以只修这一处,也可以修正它下一次看到的环境。前者提高一次任务的成功率,后者提高整条生产线的信任度。这就是标题里的「信任系统」:不是一个提示词,是能被运行、检查和持续维护的约束集合。视频那页幻灯片的标题是 whenever you correct your agent——每次发现自己在纠正 agent,都该问:这次问题落在哪一层?另一句值得记住的话来自 pstack:「It compiles」 is not evidence——完成条件必须连接到真实产物,不能停在编译器的绿灯上。